Model Discovery Agent: LLM-assisted Bayesian Experiment Design for Data-efficient Discovery of Mechanistic World Models
核心思路
目标是用尽量少的实验学到一个可解释、能回答“如果我这样干预会怎样”的机制世界模型。MDA 维护一个候选模型池,用近似贝叶斯推断给每个模型打分(对结构、参数、隐状态轨迹三层都做推断),再挑选能让这些候选模型预测分歧最大的实验去做。LLM 只在一个地方出场:当前最好的模型预测失败、说明真模型可能不在池里时,由它提出新的模型结构。所有数字(参数后验、边际似然、模型后验、实验打分、预测)都由数值推断计算,不由 LLM 给出。
1. 背景与问题
机制世界模型由有科学含义的模块组成,像结构因果模型一样,不仅能预测“会发生什么”,还能回答“如果我做了动作 会发生什么”,例如给病人用一种新药。难点有三:
| 难点 | 说明 |
|---|---|
| 被动数据不够 | 含隐变量的模型通常无法只靠观测识别,需要主动扰动系统、看它如何响应 |
| 实验很贵 | 一次化验、一次临床试验都有成本,所以关键是数据效率:用尽量少的实验学到够用的模型 |
| 真模型可能不在候选里 | 这称为 M-open:初始假设空间可能不包含真相,必须能按需扩充 |
经典的贝叶斯实验设计(BED)解决“选哪个实验信息量最大”,但假设候选模型是给定的;LLM 擅长提出新假设,但不擅长做概率计算。MDA 把两者分工组合。
交互协议。 智能体面对一个黑箱动力系统。一次实验设计 包括三部分:对系统参数的干预 ()、可选的初始状态 ,以及给出输入序列 的策略 。智能体先拿到背景描述 和少量初始数据 ,之后有 次机会,每次设计一个实验、观测一条轨迹 、更新信念。
评测方式。 评测看的是对没见过的实验的预测,而不是是否恢复出唯一的“真机制”,因为不同的隐变量模型可能给出几乎相同的干预预测。具体做法是:给定新实验及其前 步观测,预测后续某个函数 的后验预测均值,用归一化 MSE 计分。
2. 方法与创新
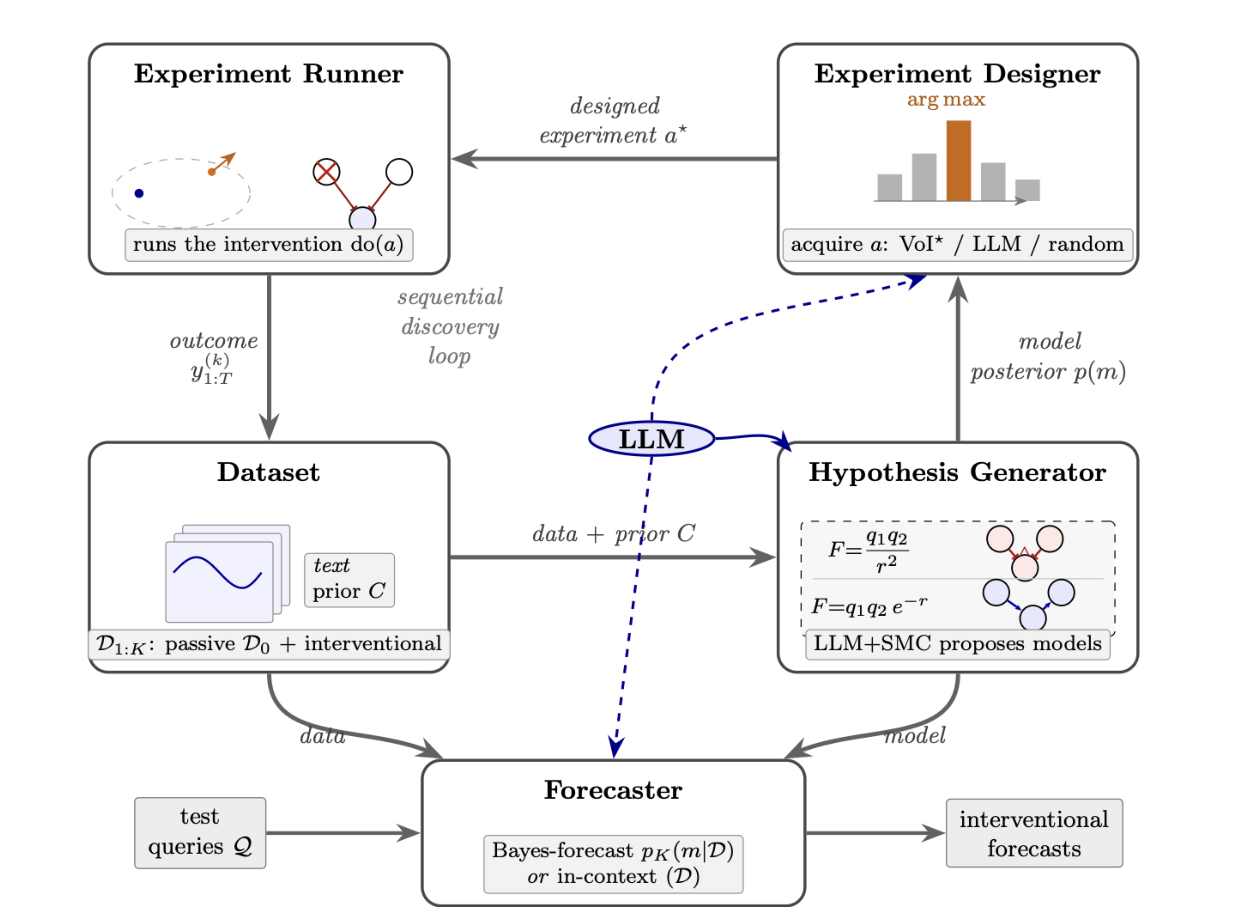
原论文图 5,v5 PDF 第 20 页。实验设计器按 VoI 选出实验 → 运行干预、得到轨迹 → 加入数据集 → 假设生成器(LLM + SMC)提出并给模型打分 → 模型后验 再交给设计器;预测器用后验对测试查询做干预预测。
世界的三层表示
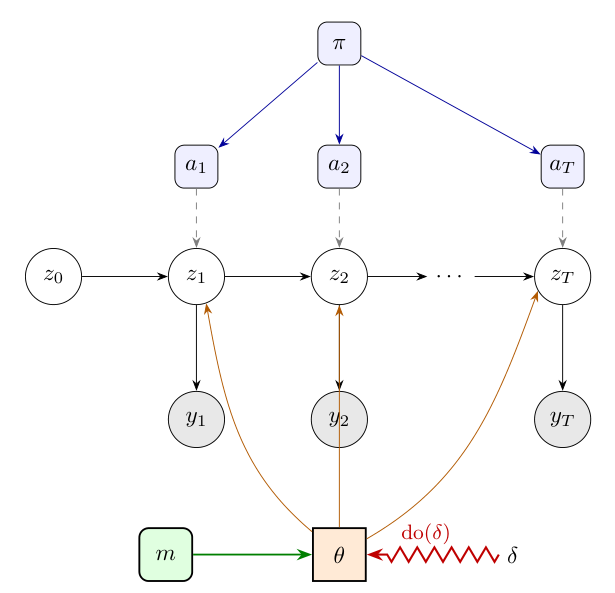
原论文图 1,v5 PDF 第 4 页。结构 (绿)选定参数化机制 (橙), 支配隐状态轨迹 (白),轨迹产生带噪观测 (灰);策略 给出输入 (蓝),干预 把 改为 。
MDA 把未知世界写成一个状态空间模型:
| 层 | 是什么 | 神经元例子 | 推断方法 |
|---|---|---|---|
| 结构 | 有哪些隐变量、谁依赖谁、函数形式 | 有哪些离子通道机制 | 在有限候选池上枚举,用贝叶斯公式归一化 |
| 参数 | 数值参数 | 各通道的电导与门控动力学 | 回火 SMC 估计后验与边际似然,或 MAP 优化 + BIC 近似 |
| 隐轨迹 | 观测不到的状态 | 电压与各通道门控变量 | 随机动力学用 bootstrap 粒子滤波,确定性 ODE 直接积分(或用 EKF) |
内层用粒子滤波估似然、外层用 SMC 估参数后验,是 SMC² 的嵌套结构;最外层不再采样,而是对候选模型逐个打分。三个基准的复杂度依次递增:ChemBench 是静态代数式(没有时间维),GlucoseBench 是部分观测的确定性 ODE,NeuronBench 是部分观测的随机微分方程(SDE)。
给模型打分:边际似然
模型后验 ,其中边际似然
在参数先验上做平均,自带奥卡姆剃刀:参数多、过于灵活的模型,会把先验概率摊在大量拟合不了数据的参数上,边际似然自然变低。必要时再加显式复杂度先验 ( 为自由参数个数)。计算上可以用回火 SMC,也可以用 BIC 近似,即 ;后者更便宜,在化学基准上预测反而更好。
LLM 只在一处出场:扩充假设空间
贝叶斯公式只能在已有候选之间挪动概率,无法创造新模型。所以每次拿到新数据时,MDA 先做一次预测检验:
- 吸收新数据之前,用当前后验最高的模型预测这次实验的结果,算相对误差(顺带回测旧数据,取中位数);
- 误差超过阈值 ,说明当前假设空间可能不够,于是调用 LLM:输入背景、观测摘要、当前模型池以及各模型的残差,让它提出若干新结构;
- 新模型可以只是对旧模型的局部修改(加一个抑制项、加一个隐状态),不要求一次猜对;
- 加入后重新计算所有模型的后验,保留前 个;最多重复 轮。
反过来,当最高权重足够大、拟合也够好时,可以把池子缩小以节省计算。但作者强调要保留一定多样性:即使后验已经集中在一个模型上,多样的候选库也有利于后续搜索,这一点与 FunSearch 的进化搜索相同。
初始池可以包含领域里的经典模型(例如 9 个经典酶动力学定律),再加上 LLM 根据背景提出的候选;入池只检查能否执行、参数界是否合法,不看预测表现。
选实验:让候选模型尽量“吵起来”
理想的准则是期望信息增益(EIG),即做完实验后,对“哪个模型是真的”的不确定性能减少多少:
其中 是模型 (参数按后验积分掉)对实验结果的预测分布。第一项是总的预测不确定性,第二项是每个模型内部无法消除的噪声,二者之差就是“因为不知道哪个模型对”而造成的那部分不确定性。
混合分布的熵没有闭式解。MDA 用高斯矩匹配近似,再把对数行列式换成迹,得到实际使用的准则:
是模型 对实验 的平均预测, 是按后验加权的总平均。直观地说,就是挑那个让各个可信模型的预测彼此相差最远(相对于观测噪声)的实验:做完它,错的模型最容易被淘汰。连续的设计空间用 CMA-ES 优化(化学有 7 个连续输入),有限菜单则直接枚举(血糖 48 个模板,神经元 90 种电刺激方案)。
默认只针对“区分模型”,也可以换成连同参数不确定性一起降低的联合版本。
预测
把模型后验转成对新实验的预测,可以做贝叶斯模型平均:
也可以简化为只用 MAP 模型及其参数直接代入。若测试时给了前 步观测,就先用滤波估计 时刻的隐状态,再往后推。
一轮循环
D ──▶ 各候选模型:拟合参数 + 估计边际似然 ──▶ p(m | D)
                                                │
             选实验 χ* = argmax 加权模型分歧 ◀────┘
                    │
            运行干预 do(χ*),观测轨迹 y
                    │
   预测检验:吸收 y 之前,MAP 模型预测得准吗?
        ├─ 准:把 y 并入 D,更新后验
        └─ 不准:LLM 读模型池与残差,提出新结构 → 重新打分、剪枝(≤ R_m 轮)
                    │
            可选:后验集中且拟合好时缩小模型池 ──▶ 下一轮
两个发现过程的例子
- ChemBench 的一个世界(真实定律为 Michaelis–Menten + 竞争性抑制 + Arrhenius 温度项):第 6 次和第 15 次观测后预测检验失败,触发扩充;第二次扩充加入的模型很快占据后验,留出集误差随之骤降。第 8 次观测时,模型池从 14 个缩到 6 个。
- GlucoseBench 的一位虚拟病人:从 4 个房室 ODE 出发,LLM 加入“胰岛素分布”和“传感器延迟”两个记忆型隐状态,3 次实验后得到一个 6 状态的稀疏模型,BIC 权重达到 0.996。
论文没讲清的
- 触发扩充的阈值 、扩充上限、缩池门槛都按领域单独设定,没有统一的选取方法。
- 扩充后的“再检验”是在已见过的数据上做的,作者也承认这不是新的前瞻性证据。
- LLM 提出模型时可以在看过数据后自定参数界,相当于依赖数据的先验,会抬高边际似然;作者把结果称为近似的预测性权重,而非校准过的贝叶斯因子。
3. 应用与效果
LLM 统一为 GPT-5.6-Luna(中等推理强度),附录的 BoxingGym 实验用 Claude Opus 4.7。
| 基准 | 任务 | 预算 | 结果 |
|---|---|---|---|
| ChemBench(57 个世界) | 由 7 个可控输入学酶反应初速率的代数定律 | 3 + 22 次 | 样本效率明显高于 LLM-AutoSciLab(LLM + PySR 符号回归)和 LLM 直接上下文预测 |
| GlucoseBench(30 位虚拟病人) | 部分观测的 13 维 ODE,只看血糖和胰岛素 | 2 + 4 段 | 优于 ARX、SINDYc 和两种上下文预测基线 |
| NeuronBench(作者新建,6 种神经元) | 部分观测的随机 Hodgkin–Huxley SDE | 2 + 8 段 | SDE 建模明显优于 ODE 近似(示例中误差 0.38 对 7.41),两者都优于上下文预测 |
两组控制对比支持两个设计选择(都在 ChemBench 上):
- LLM 扩充的作用:与只用 9 个经典定律、完全不调用 LLM 的版本相比,15 次观测时通过率高 33.3 个百分点;在 48 个真定律不在初始库里的世界上,高 39.6 个百分点。
- 主动选实验的作用:与随机选实验相比,15 次观测时误差降为 0.31 倍(BIC)和 0.13 倍(SMC)。
证据边界
- 评测的是对新干预的预测,不是机制识别;作者明确说有限的留出测试不能证明因果可识别。不同机制若在测试实验上预测相同,就无法区分。
- 归纳式方法(MDA)与 LLM 直接预测(转导式)的计算量没有对齐:前者大部分时间在数值拟合,后者全在 LLM 内部。
- ChemBench 主图只用了 171 个格子中的 115 个,即 LLM-AutoSciLab 在每个预算下都能评估的那部分。NeuronBench 由作者自建,每个条件 6 个世界 × 3 个种子。
- 实际使用的实验设计准则(迹形式的加权分歧)是 EIG 的近似,作者不保证其最优点与真实 EIG 一致;不同领域的推断后端和超参数也各不相同(见原文表 2)。
- 单一作者;v5 是大改版,新增了 GlucoseBench 和 BIC 实验,并改写了主线叙述。只用了一个主力 LLM,未系统比较不同模型。
对 CKG 的启发(阅读判断)
MDA 的分工很清楚:LLM 负责提出结构,所有数字由推断计算,而结构是可执行模型,因此能被打分、被淘汰。对知识库来说有三点可借鉴:一是同时保留多个相互竞争的假设及其后验权重,而不只存“当前最好的”;二是用“吸收新数据前先预测”的前瞻检验来决定何时需要新假设,并把残差交给提议者;三是下一步实验应当选在竞争假设分歧最大的地方,可以把“哪个实验能区分 A 和 B”作为知识条目的一部分记录下来。它不关心参数是否可识别,只关心预测;这正是 LLM-IDEA 要补的那一块。
相关:LLM-IDEA 把 MDA 作为主要对照,追问“有没有任何实验能区分这些参数”;MSA 同样让 LLM 按问题合成概率模型、由推断引擎计算;LLM-SR 在静态数据上做方程发现,不主动设计实验;RWM 在 AI 研究场景中预测实验结果、只执行最有希望的候选。
依据:原文 v5,问题定义见第 2 节,方法概览见第 3 节,三个基准见第 4.1–4.3 节,完整算法见附录 A.3(算法 2)及 A.8–A.9(扩充、预测检验、VoI 推导),LLM 扩充与主动设计的消融见附录 B(图 6、图 7);核对日期:2026-11-02。