Modeling Open-World Cognition as On-Demand Synthesis of Probabilistic Models
核心思路
不要求一个固定世界模型预先容纳所有变量,而是遇到问题后,临时选取相关背景、补出依赖关系,生成一个小的概率程序,再在程序里统一推理。LLM 负责“该建什么模型”,概率推断负责“在这个模型里怎样更新信念”。
1. 背景与问题
固定的贝叶斯模型能连贯地处理其内部变量,但很难处理突然出现的新因素。例如根据划船比赛的胜负估计选手实力,原模型只有“力量、努力程度”;现在又听说某人受伤、喝了能量饮料或第一次参赛,就要决定是否加入新变量,以及它如何影响结果。
把所有可能因素提前放入一个模型,既难以穷尽,也会让推断昂贵。只让 LLM 用自然语言回答,又可能对相互关联的问题给出不一致判断。论文研究的是开放世界中的人类判断如何兼具灵活性与局部一致性,并给出一个计算实现。
与“从知识库检索”的区别
MSA 是一般架构假说;本文实现主要通过提示 LLM 生成相关背景,从模型参数中的知识提取信息,并非已有一个显式、持久、带来源的知识库。把外部 CKG 接到这里是可以借鉴的扩展,不能当作本文已经实现的功能。论文提供了全局固定模型之外的选择,没有证明全局因果图在所有任务中都不可行。
2. 方法与创新
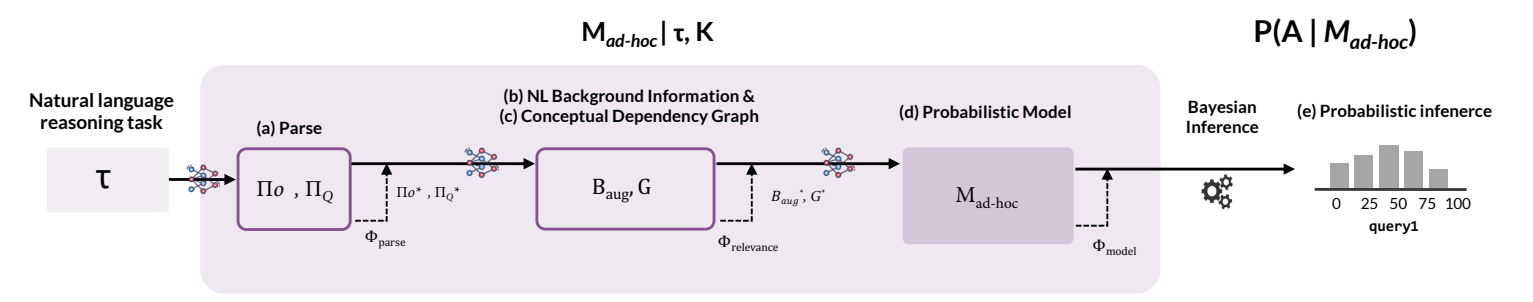
原论文图 2,v2 PDF 第 4 页。重点看模型构造与模型内推断的分工;二者采用不同的评价标准。
输入分为背景 、观察 、问题 ,记作 。执行流程如下:
| 阶段 | 做什么 | 产物 |
|---|---|---|
| 解析 | 将观察与问题翻译成条件、查询表达式 | ,可以先含占位函数 |
| 补充相关背景 | 提出与当前问题有关的变量、分布与关系 | 扩充后的自然语言背景 |
| 组织依赖 | 与背景一起提出概念依赖图 | ,帮助后续程序生成 |
| 合成程序 | 定义随机变量及其依赖,补全占位函数 | WebPPL 概率程序 |
| 推断 | 根据观察约束,对查询变量采样 | 条件分布 |
解析、背景和依赖图阶段会生成多个候选,用 LLM 评分并保留较优候选;程序阶段采用可执行性检查,保留能编译并返回推断结果的程序。本文使用 Llama-3.1-70B + WebPPL + 拒绝采样。
其目标可概括为:
其中 是全部背景知识, 是这道题需要的一小部分。这是架构希望达到的近似关系,不是已证明的检索充分性保证。
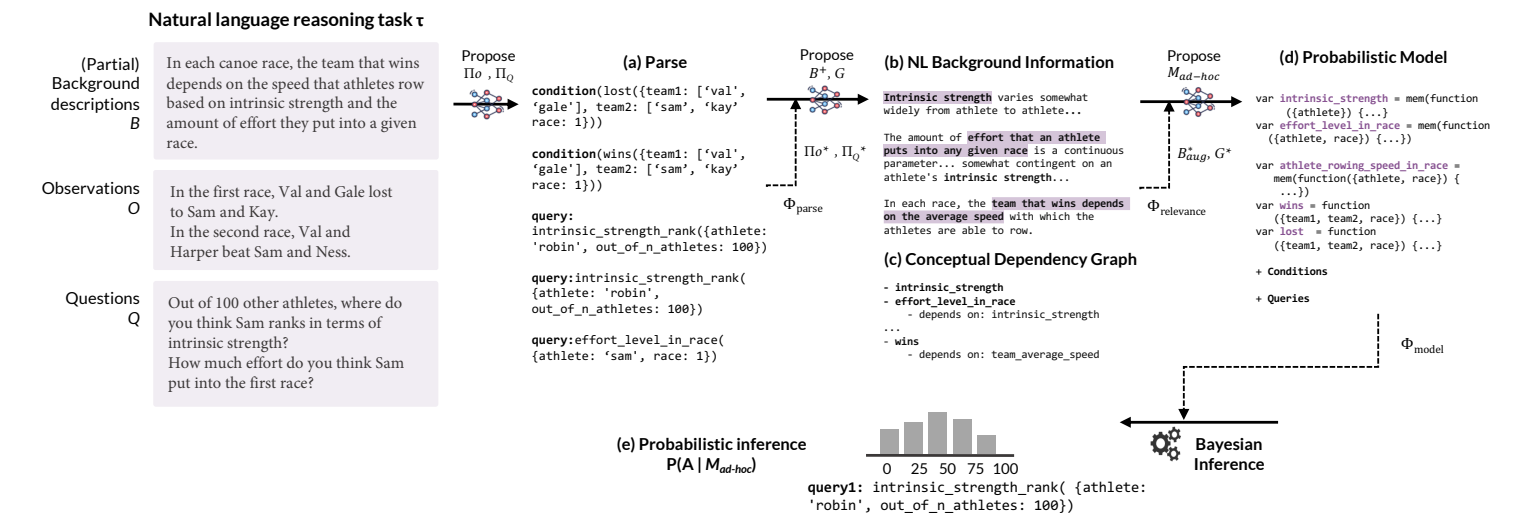
原论文图 3,v2 PDF 第 4 页。沿左到右阅读:比赛描述 → 条件与查询 → 补充背景和依赖 → 随机函数;最后依据观察更新选手属性的分布。
它与普通 RAG 的区别在于,检索或生成的内容还要编译成一个共同的可执行模型。回答不同问题时,共用同一组随机变量和约束,减少逐题编故事造成的冲突。它与传统手写概率模型的区别,则是变量集合和程序可以随任务改变。
3. 应用与效果
实验构建 Model Olympics,包含拔河、划船、冬季两项等小故事,询问选手固定属性、单场状态和未来比赛结果。三个实验逐步增加建模难度:
- 明确给出主要变量、分布特征和依赖关系。
- 只简略描述因素,让参与者和模型补充背景关系。
- 加入其他参与者自由提出的新情况,例如受伤、缺觉或经验不足。
比较对象包括手写概率模型、同一底座 LLM 的直接回答及 CoT。评价使用人类与模型平均判断的相关性,以及判断分布的 Wasserstein 距离。总体上,MSA 更贴近人类判断,尤其在要整合任意新因素的设置中;部分分布比较接近人类分组之间的差异水平。
“意外输掉一场”不必直接变成“这个人很弱”
已有比赛提示某人总体实力不错,突然输掉的一场又有受伤信息。局部模型可以把伤病与单场发挥联系起来,更新伤后表现,同时保留对长期实力的不确定性。核心价值是把多条观察放进同一个解释中,而不是独立回答每个问题。
这里测量的是与人类判断的一致程度,并非真实比赛预测准确率,更不是基础设施调优效果。模型中的分布和数值仍可能来自 LLM 的主观补全;能执行只保证程序层面的有效性。拒绝采样还有明显成本,论文没有给出任意规模模型的高效推断保证。
对 CKG 的启发(阅读判断)
可长期维护带条件和证据的机理片段,针对一个性能问题再装配局部模型;持久知识库与单次推理模型应分开。装配时记录选入了哪些片段、遗漏了哪些变量、哪些参数仍是假设。MSA 没有解决来源审计和数值校准,这两点需要 MLSYSIM 与测量补足。
相关:Compositional Modeling 研究如何选择适用模型。
依据:原文 v2,模型架构见 PDF 第 3–5 页,实验与结果见第 6–13 页;核对日期:2026-10-24。