From Models to Microtheories: Distilling a Model’s Topical Knowledge for Grounded Question Answering
核心思路
从同一主题的一组问题出发,抽出模型回答时需要的通用知识,再按“这些知识能共同支持多少条解释”筛选一个简洁的小理论。知识价值由它能支持的推理来衡量,而不只由与问题的文字相似度决定。
1. 背景与问题
Chain-of-thought 能展示某一道题的解释,却很难回答:模型对这个主题究竟掌握了什么,这些理解能否反复用于新问题?逐题生成的知识还可能重复、过于具体,或缺少关键前提。
Microtheory 指一组围绕主题组织的自然语言陈述,例如力学中的牛顿第二定律。它应当尽量一般、简洁、少冗余,并能通过多步推理支撑许多问题。这里的“小理论”是可查看的文本知识集合,正确性仍需另行检查。
第 2 节讨论的前序工作包括:
| 方向 | 已有能力与本文的切入点 |
|---|---|
| Cyc/形式逻辑 microtheories | 已将知识按主题和共同假设组织成局部理论。本文使用自然语言和学习式文本蕴含,降低手写形式理论的门槛。 |
| 模型事实抽取、BeliefBank、belief graphs | 能显式呈现模型相信的事实及部分关联;本文进一步选择一组能跨题复用的主题知识。 |
| WorldTree | 人工整理科学问答的支持事实,成本较高。本文尝试自动构建类似资源,并与其比较。 |
| TreeWise、IRGR、Entailer 等蕴含推理 | 已能检索并组合文本前提,构造支持结论的树;本文用这些推理轨迹反过来筛选知识库。 |
它并非从实验重新发现科学规律,而是将 LLM 已形成的主题知识外显,再根据下游使用情况压缩。
2. 方法与创新
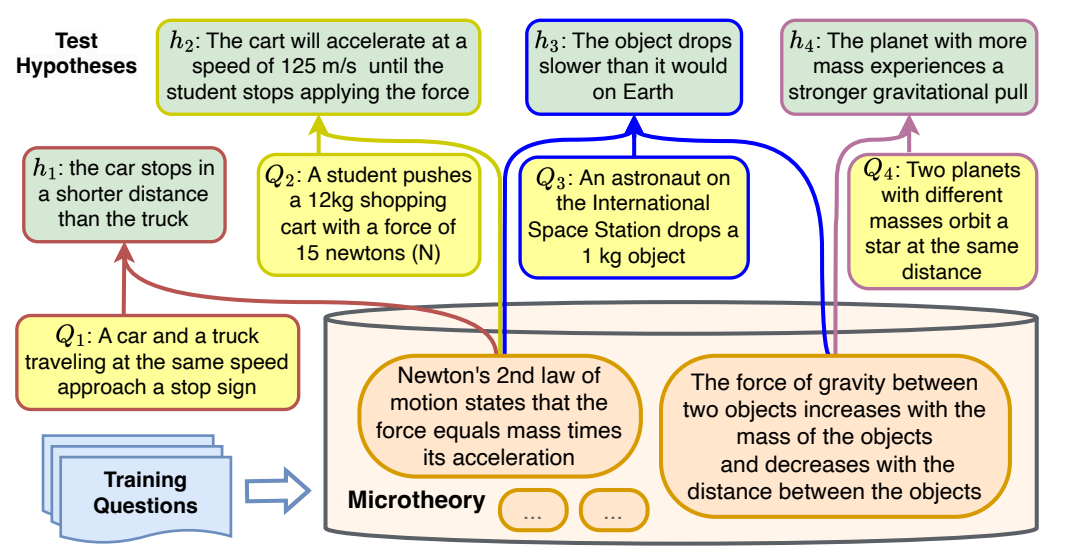
原论文图 1,v2 PDF 第 2 页。不同问题共享力、质量、加速度等一般原理;笔记关注这种知识复用关系。
原图勘误
Q2 中 12 kg 物体受 15 N 合力,对应加速度应为 ;图中 h2 写成了 125 m/s 的速度表述。原图用于说明知识复用结构,其这处数值结论不能照用。
从问题生成通用事实池
对每道训练题,提示 LLM 给出支持答案的知识及推理步骤。少量提示示例来自 EntailmentBank。随后过滤只描述题中具体人物或场景的陈述,保留一般性知识,合成事实池 。
这让主题由一组实际需要回答的问题界定。例如“力学”太宽泛,而一组质量、受力和运动题能明确哪些知识值得保留。训练题的分布也因此会影响知识库覆盖范围。
先消除表达冗余,再分析推理用途
独立生成的事实常重复。系统先用 SBERT 去掉近似改写,再用 NLI 模型检查蕴含:若保留的一条陈述已能推出另一条,就移除后者,得到压缩池 。
接着让 TreeWise 尝试从 推出训练答案,记录每条成功推理树所需的叶子事实。同一答案可能有多种证明方式,因此会得到多个可替代的支持事实集合。
这里的“蕴含”是模型判断文本前提是否合理支持结论,属于近似推理;它不像形式定理证明那样保证逻辑有效。
知识预算下,怎样选择要保留的事实?
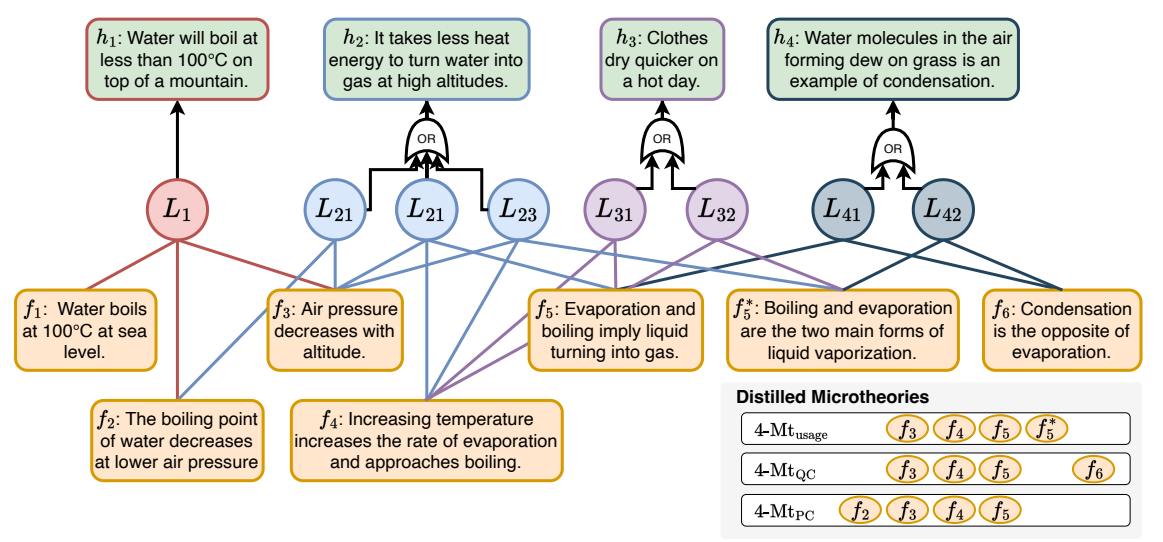
原论文图 2,v2 PDF 第 5 页。多条事实可能承担相同推理角色;单独统计频次会保留功能冗余。
| 选择方式 | 目标 | 主要取舍 |
|---|---|---|
| Usage | 选被最多问题使用的 条事实 | 简单,但两条可互相替代的事实可能同时占用预算。 |
| Question Coverage(QC) | 让尽可能多的问题至少保留一套完整支持事实 | 重视能完成的解释,但可能完全放弃一些较难覆盖的问题。 |
| Partial Coverage(PC) | 最大化各题最佳支持集合被保留的比例之和 | 允许不完整支持,让有限知识在更多问题间分配。 |
例如某题需要三条前提,只保留两条时,QC 认为该题尚未被覆盖,PC 则计入 。实际解题时仍需要把缺失的前提从其他资料中补齐;部分覆盖不等于已经证明答案。QC、PC 采用论文给出的优化规划来求解。
解题时,小理论与资料库一起使用
系统将 microtheory 与 Wikipedia、教材等资料合并检索,用蕴含引擎构造回答。一般原理来自小理论,题目特有的长尾事实可由大语料补充。贡献主要是问题驱动的知识外显、按推理支持筛选,以及对主题知识复用性的评估,不要求知识必须存成图。
3. 应用与效果
实验覆盖基础科学 ARC 与医学 MedQA,按相近主题划分训练/测试;事实生成使用 GPT-4,推理使用 TreeWise,并补充开放模型实验。
| ARC 指标 | 论文结果 | 应如何理解 |
|---|---|---|
| 正确答案可被完整 grounding 的比例 | 基础语料约 84%,加入完整事实池约 92% | 引擎更常找到有文本叶子支持的推理树。 |
| 多项选择准确率 | Wikipedia 69.2%;加入 1000 条筛选事实约 73%;完整事实池约 78% | 少量领域知识有帮助,但越压缩越可能丢前提。 |
| 1000 条知识的三种优化方式 | QA 准确率接近,均优于随机抽样 | PC 的覆盖优势没有直接变成明确的 QA 优势。 |
数据来自第 5 节。论文的人工检查主要由两名高年级医学生评价知识对考试的相关性,支持“筛出的内容更有用”,不能代替完整的事实审校。
知识单元为何比逐题答案更有价值?
“力等于质量乘加速度”可以用于不同物体、质量和受力的题目。保存每道题的具体答案不能提供同样的复用;但只留下这条公式也未必足够,还需单位、合力、适用模型及题目条件。本文用支持集合来暴露这类缺失前提。
医学结果较弱:许多题依赖特定疾病、症状等长尾事实,较难被少数通用原理覆盖。论文还用学习曲线外推覆盖所需问题数;这是分布相关估计,不是知识库完备性证明。
证据边界
知识与部分推理检查都由模型生成;有“可查看的支持链”不等于来源独立、事实正确或推理无误。近似去重也可能丢掉条件差异。实验支持的是同主题问答中的复用收益,尚未验证复杂工程分析与实现能力。
对 infra 专业知识库的启发(阅读判断)
可先收集显存核算、通信分析、性能解释等代表问题,检查每种分析需要哪些前提,再挑选能跨题使用的知识。将“知识是否真实”“能支持什么推理”“覆盖哪些问题”分开检查。接着可读 Compositional Modeling,研究怎样按问题选择适用的模型片段。