Compositional Model Repositories via Dynamic Constraint Satisfaction with Order-of-Magnitude Preferences
核心思路
先用领域片段构建“可能的模型空间”,再把选择哪些机制、采用哪些模型,以及它们的依赖和冲突,翻译成动态约束问题。满足硬约束之后,再根据用户给出的符号偏好选择合适的组合。
1. 背景与问题
1991 年的 Compositional Modeling 已研究怎样按任务组合专业知识。这篇进一步处理:建模决策会相互激活、存在不合法组合,而且合法方案之间未必有唯一的客观最好选择。
生态系统是它的主要场景。一个种群如何增长、是否受到捕食、两个种群是否竞争,各自有多种模型;采用某种捕食模型,又可能要求相关种群采用相容的增长表示。
相比设备的部件分解,这类系统更突出相互作用与建模选择之间的依赖。把所有模型机械拼接,会导致重复定义、缺少必要机制或前提不相容。
相关基础包括三类工作:
| 前序路线 | 提供什么 | 本文的结合方式 |
|---|---|---|
| 组合建模与 ATMS | 模型片段、假设依赖及不一致组合 | 组织一个保留多种替代选择的模型空间。 |
| Activity-based dynamic CSP | 只给被条件激活的决策变量赋值 | 表达“选了某模型,才需要进一步决定某参数/机制”。 |
| 定性偏好与数量级推理 | 表达不必精确量化的偏好和优先程度 | 在合法组合之间做选择,并保留无法比较的情况。 |
这里的 dynamic 主要指变量是否激活取决于其他选择,不应直接理解成在线学习或随时间更新的系统模型。
2. 方法与创新
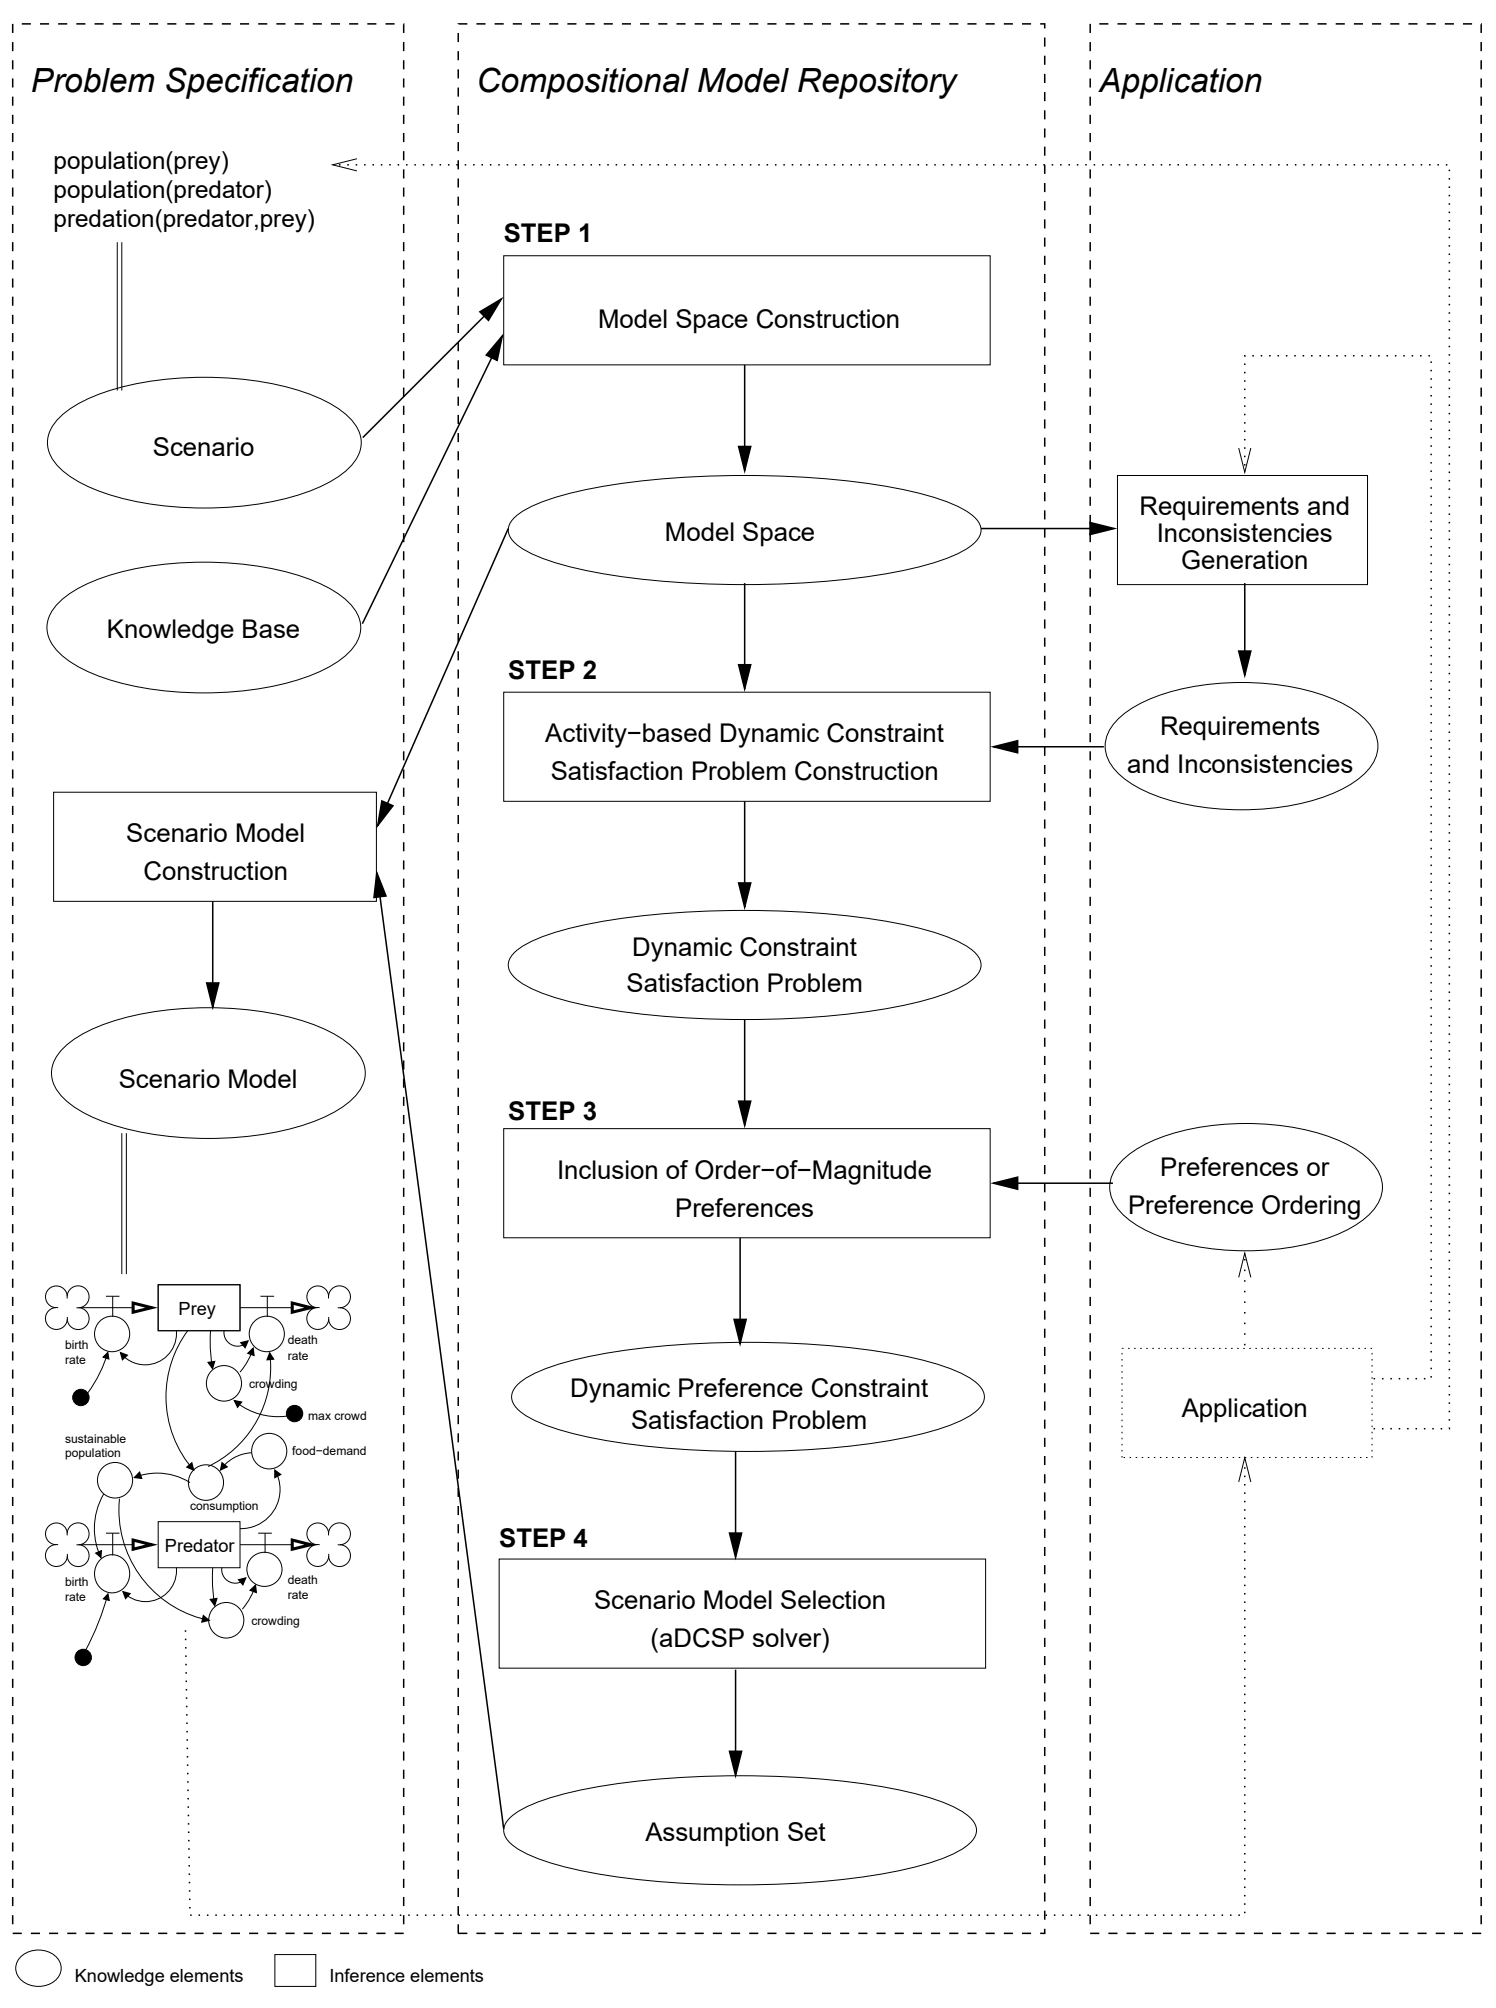
原论文图 4,期刊第 525 页/PDF 第 27 页。中间四步先表示候选空间,再构造约束和偏好,最终返回假设集合。
用片段描述参与对象、关系及建模假设
知识库包括参与者类型、模型片段和需要满足的属性。片段可从已有参与者生成新参与者及关系,例如从两个种群及捕食关系引入捕食流。
假设主要区分:
- Relevance assumption:当前模型是否考虑某种现象,如种群竞争。
- Model assumption:考虑后,用哪一种表示,如指数或 logistic 增长。
关系还区分能否组合。多个局部流量贡献可以聚合;对同一量给出互相替代的完整定义,则不能不加检查地同时使用。
第一步:先构造模型空间,而不是立即选定一个模型
给定 scenario 和知识库,系统实例化可能有关的片段,以 ATMS 保存参与者、关系、假设及它们的支持依赖。某个关系成立依赖哪些选择、哪些假设组合矛盾,都能被追踪。
因此 model space 是候选与依赖的表示,scenario model 才是一份具体结果。保留候选空间,便于后来改变任务要求或偏好,而不必把每种结果预先手写一遍。
第二步:将依赖与冲突翻译成动态 CSP
其基本形式为:
是建模决策, 是各决策的备选值, 是兼容性硬约束, 是活动约束。
| 约束 | 回答什么问题 | 示例 |
|---|---|---|
| Activity | 这个选择现在是否需要做? | 不考虑捕食时,无须决定其具体函数形式。 |
| Compatibility | 同时采用的选择是否相容? | 某捕食表示要求相应增长模型;不兼容组合被排除。 |
| Purpose-required properties | 当前分析必须具有哪些内容? | 所选片段必须提供应用要求的参与者或关系。 |
只对激活变量赋值,同时满足相关硬约束。相比普通 CSP,不必为完全无关的建模分支强行做决定。
第三步:用符号偏好表达“更合适”
合法选择不一定有客观统一排序。论文给模型选择附上 order-of-magnitude preferences:使用符号偏好量、相对重要等级和部分序,而不是要求用户给每种选择精确打分。
不同重要等级可表达强弱优先;高层偏好相同时,低层偏好仍可用来细分。一些方案也可以保持不可比较。因此它不等于概率、置信度,也不等于把任意几个数字简单相加。
第四步:搜索满足约束且偏好最优的假设集合
问题变为 aDPCSP。求解器结合当前偏好与可能达到的偏好界限,引导对部分赋值的搜索;找到合法且偏好最优的假设集合后,再从 ATMS 中取出由其支持的关系,组合为具体模型。
增量在于把现象相关性、模型选择、动态依赖、硬合法性和软偏好放进同一个可求解框架,复用约束求解研究,而不为每个领域重新编写全部组合搜索逻辑。
3. 应用与效果
主要例子包含一个捕食者、两个相互竞争的猎物种群。知识库提供 exponential/logistic 增长和 Lotka–Volterra/Holling 捕食等替代片段。
怎样从备选知识得到一份模型?
系统先枚举相关增长、捕食和竞争片段,排除不相容组合,再按用户偏好选择 logistic 增长、Holling 捕食等假设。最终输出对应的种群变化方程,包含增长、死亡、竞争和捕食项。公式来自已给定的片段,而不是系统凭观测自动学出来的。
论文还报告用于地中海植被 MODMED 模型相关工作的知识库:约 60 个模型片段和 4 个属性定义,构建约需两个人周。这说明已有领域知识可被编码成可复用库,同时也暴露了知识工程成本。
验证以形式框架、算法和生态建模示例为主,没有现代多任务准确率或大规模运行时间对照。产生符合手写知识与偏好的模型,是它所展示的能力;预测真实生态系统是否准确,还需要参数、数据和独立验证。
适用边界
组合空间仍可能指数增长,复杂度分析主要是纲要性的。种群聚合/拆分等粒度选择还需扩展;偏好及合法约束都依赖领域专家提供。满足约束并不能证明假设符合现实,更不能替代对模型的实测校准。
对 infra 专业知识库的启发(阅读判断)
将“是否需要考虑某机制”“采用哪个近似”“哪些组合合法”“合法方案中偏好什么”分开表示。例如先明确问题是否需要通信、排队或显存机制,再检查相关表示的前提。可把硬约束交给求解器,把证据不足或偏好不明确的选择保留为显式未定项,而不要求 LLM 悄悄做完所有建模决定。