AI Assistants to Enhance and Exploit the PETSc Knowledge Base
核心思路
专业软件的知识散落在文档、源码、维护者讨论和专家经验中。PETSc 团队把这些来源与检索、重排序、交互记录和维护者评审结合,帮助助手答专业问题,也让日常讨论逐步补入正式知识库。
1. 背景与问题
PETSc 是用于可扩展数值求解的长期软件项目。理解它需要数值方法、API、配置与实现经验;即使资料很多,用户也可能不知道该搜哪个术语,维护者还需反复解释文档没有写清的细节。
通用 LLM 会编造貌似符合命名惯例的求解器或参数。仅扩大上下文并不能解决资料找不到、专业关键词漏检、讨论未经审查、知识没有沉淀等问题。
第 1、6 节涉及通用代码助手、HPC 开发、遗留代码 RAG 等前序工作。本文沿用成熟的检索和重排序组件,其贡献主要是把它们放进真实数值软件社区的知识流转与评估流程,而非提出新的推理算法。
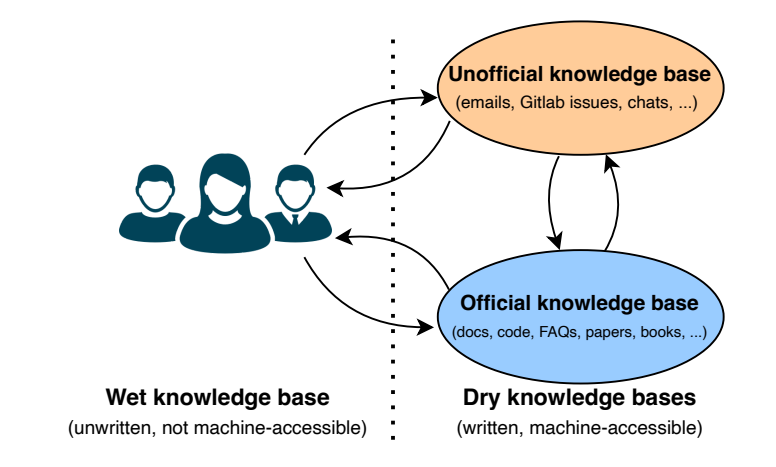
原论文图 1,v2 PDF 第 2 页。知识能否被机器访问,与是否经过正式评审,是不同维度。
论文区分:
| 类别 | 含义 | 为什么要保留区别 |
|---|---|---|
| Wet knowledge | 只存在于专家脑中的理解 | 尚未写下来,不能指望检索系统直接找到。 |
| Dry knowledge | 已写成机器可访问材料 | 包含正式文档,也包含未经审查的讨论。 |
| Official | 经过维护、审查的源码、文档等 | 经项目流程认可,但仍需考虑版本和适用条件。 |
| Unofficial | 邮件、聊天、问题讨论等 | 可以很有价值,也可能是猜测、临时方案或已过时意见。 |
目标包括两个方向:让助手使用既有专业知识,以及从日常交流中捕获专家理解,经过评审后完善正式资料。
2. 方法与创新
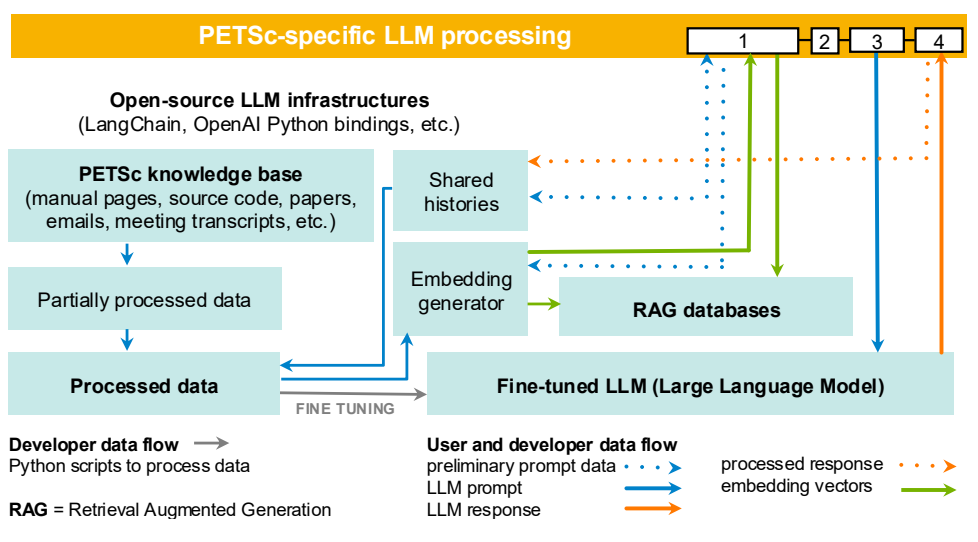
原论文图 3,v2 PDF 第 4 页。图也包含规划中的扩展;文中主要落地和评估的是文档 RAG、重排序及社区机器人,不能据图中的模型框推断已完成参数微调。
让文档能够被定位和追查
将 Markdown/Sphinx 文档清洗、切块,用 embedding 建立向量数据库,并保留文档链接。不同 embedding 可对应不同索引。论文也计划将邮件和其他材料纳入,但不能把未来支持范围都算成当前已评估的语料。
查询时先做向量召回;若包含 KSPSolve 这类对应正式手册页的名称,就额外补入该页面。语义检索与精确 API 名匹配互补,避免专业标识符被一般相似度检索漏掉。
先广召回,再用重排序筛出真正有用的段落
实验先取 个候选,重排序后留下 个供 LLM 使用。重排序重新检查问题与候选段落的相关性,减少只在主题上相近却无法解答问题的材料。
这不只是“把 top-k 改小”:如果初次召回的第 5–8 项包含关键条件,重排有机会把它们移到最终上下文。实验比较了 NVIDIA 与 Flashrank,最终因速度选择 Flashrank。
用交互记录支撑纠错与评估
系统记录问题、答案、提示、时间、生成模型和 embedding,提供盲评及标注错误部分的接口。维护者可查看、控制传给 LLM 的上下文,从而把“答案错了”进一步定位为检索缺失、材料不适用或生成错误。
输出还可经过格式处理、代码块检查等步骤。编译通过只能检查部分实现问题,不能验证数值方法是否适用。
让社区反馈进入正式维护流程
Discord 机器人连接用户、助手与维护者;项目希望通过问答把未写出的专家知识显式化,再形成文档改进。正式知识仍经过项目评审,不能把模型回答直接等同于维护者认可的结论。
值得借鉴的增量是知识来源分层、面向专业术语的检索适配、可复查的交互与专家盲评。RAG 和 reranking 本身已有成熟方法,这里主要展示具体应用怎样落地。
3. 应用与效果
评估包含 37 个 PETSc Krylov 方法问题,来自真实用户询问,包括文档不能直接回答的开放问题。两名有十年以上经验的开发者盲评,评分范围 0–4;报告使用 GPT-4o 与 text-embedding-3-large。
| 与无 RAG 基线比较 | 改善的问题数 | 降低的问题数 |
|---|---|---|
| 文档 RAG | 20 | 3 |
| RAG+重排序 | 25 | 0 |
重排方案中 33 题获得 4 分,其余 4 题为 3 分;与普通 RAG 相比,11 题改善。这些是专家评分,不能写成自动测试通过率。
关键知识检索回来,答案才会变化
对非方阵最小二乘问题,普通 RAG 未给出具体求解器,重排方案找到了提及
KSPLSQR的关键段落。另一个案例中,普通 RAG 编造运行参数,重排方案检索到-info的正式说明后修正回答。对不存在的KSPBurb,加入专业资料后也更容易指出名称有误。
重排序使平均检索时间从 0.44 秒增至 1.05 秒;对应模型响应约 9.6 秒,额外检索成本相对有限(表 2)。
证据边界
37 题集中于一个子领域,且最优模型组合经过选择,不能据此推断整个 PETSc 或一般工程任务的稳定准确率。论文的广泛软件研发愿景尚未全部验证;知识来源分层也没有自动解决冲突、版本失效和专业推导正确性。
对 infra 专业知识库的启发(阅读判断)
先把文档、源码、维护讨论和专家解释接通,并保留来源成熟度、版本及审查状态。把这类真实可用的检索+重排方案作为基线,再判断是否需要更强的规则或推导表示。它与 Linnea 互补:前者帮助找到正确专业材料,后者展示知识怎样参与可执行的技术推导。