From Experiments to Expertise: Scientific Knowledge Consolidation for AI-Driven Computational Physics
核心思路
让科研助手把每次计算的发现连同来源保存下来,在新任务前检索,并用专门的复审会话纠错、归纳跨计算规律。重点是让计算经历逐渐形成可复用知识,同时保留结论被修订或废弃的记录。
1. 背景与问题
能完成一次模拟,不代表已经掌握该领域。科研计算中有大量参数协调、软件细节、数值收敛和方法判断;如果每次会话都从头开始,正确经验无法积累,错误解释也可能在复用中扩散。
论文把问题放在科学计算自动化、可复现工作流及经验学习之间:
| 已有方向 | 已能解决什么 | 本文关注的缺口 |
|---|---|---|
| LLM 科研与材料计算助手 | 调工具、搭流程、执行计算 | 执行成功之后,是否形成能用于后续任务的专业知识。 |
| AiiDA 等溯源基础设施 | 保存输入、计算与结果的来源关系 | 还需记录结果的解释、解释的证据及修订状态。 |
| 经验检索、反思与知识记忆 | 复用成功经验、整理教训 | 科学知识还需区分单次发现、跨案例规律与一般原则,并检查数值依据。 |
QMatSuite 的切入点是知识怎样成为计算流程的一部分,以及执行与复审为何需要分开。它提供了案例证据,不能据此断言已经获得普遍的科学专家能力。
2. 方法与创新
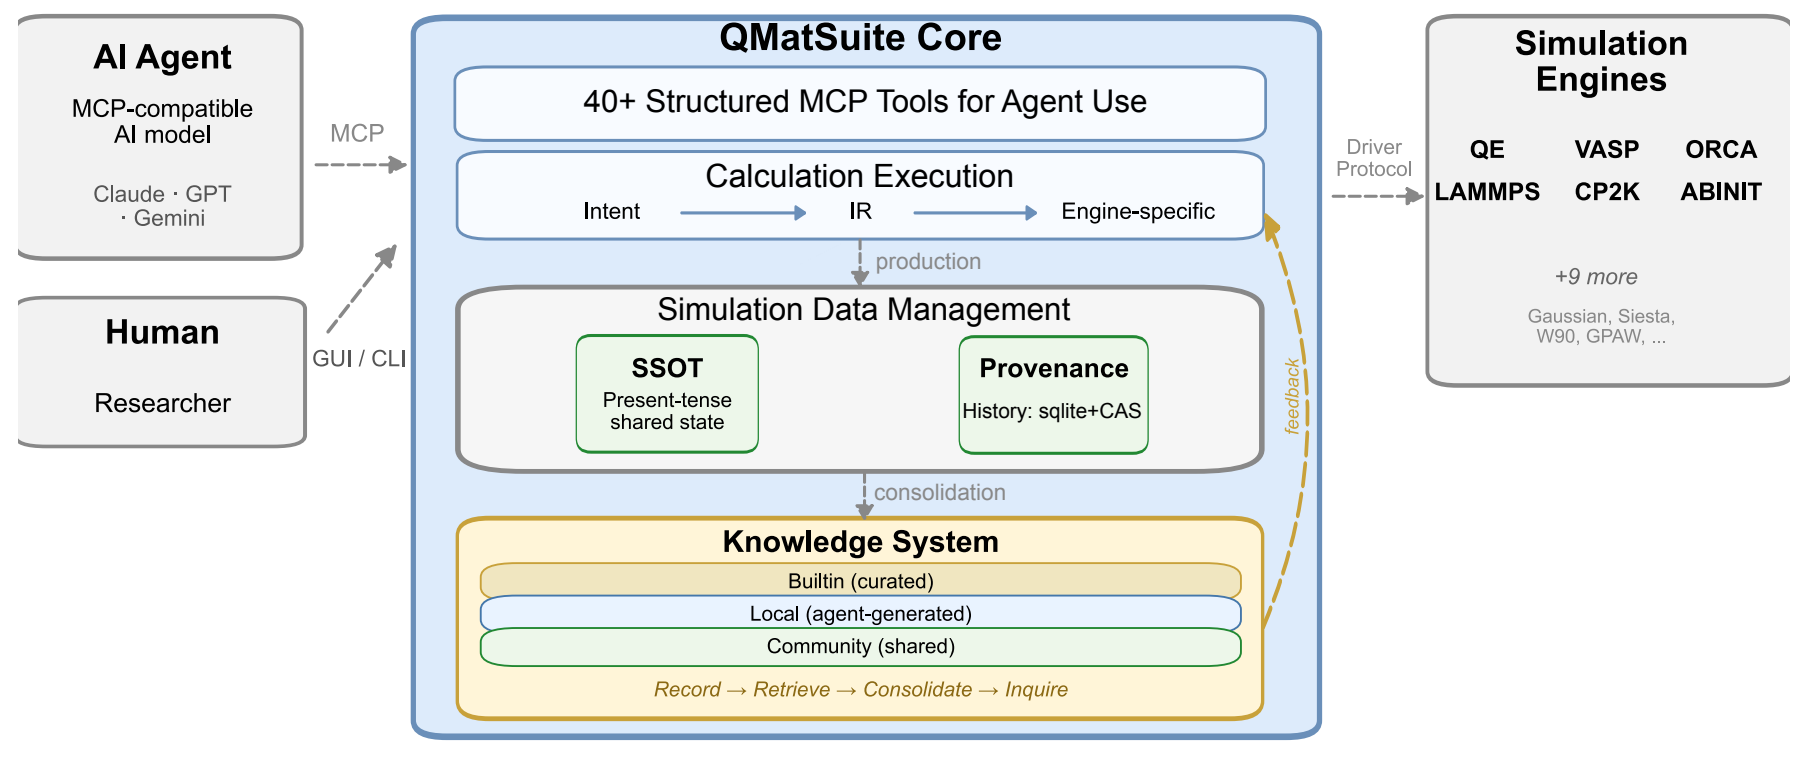
原论文图 1a,v2 PDF 第 3 页,截取架构部分。AI 工具和人的 GUI 共用计算与知识基础设施。
同一平台保存当前状态、计算历史与解释
平台将高层调用转换为不同模拟引擎的输入;AI 经 MCP 使用工具,研究者经 GUI 使用同一核心。需要区分三个层次:
- 当前项目状态:此刻采用的结构、参数和流程。
- Provenance:实际执行过哪些计算、用了什么输入、得到了什么结果。
- 知识条目:从结果或失败中提炼的解释和建议,带来源关联,可复审。
这使“测到了什么”与“据此相信什么”能够分别追查。知识来源还分为只读的 curated best practices、可读写的 agent insights 与社区知识包;本文重点评估第二类。
用分级知识表达抽象程度
| 等级 | 含义 | 例子 |
|---|---|---|
| Finding | 单个计算的发现 | 某方法对某材料的晶格常数高估了多少。 |
| Pattern | 多个 finding 支持的规律 | 某材料家族中误差随某类因素变化。 |
| Principle | 更一般的规则 | 需要更广泛支持、适用边界明确的原则。 |
等级是表示设计;实验中实际展示的高层归纳主要是 patterns,不能把所有归纳自动升级为普适 principle。
把检索与记录嵌入自然工作节点
只要求“记住有用知识”并不可靠。平台在工具前言、计算返回和结果摘要中加入提醒:配置前先查经验,报错后记录恢复方法,取得结果后保存数值发现。
这些提醒帮助积累记录,但不保证形成综合理解。论文分析的执行会话中,没有自动生成 pattern 级条目;大多数知识记录发生在会话末尾。因此系统另设专门的 reflection/review 会话,集中检查错误、归纳跨材料规律,并引用支持 finding 的 ID。
复审要能否定“看起来更接近答案”的建议
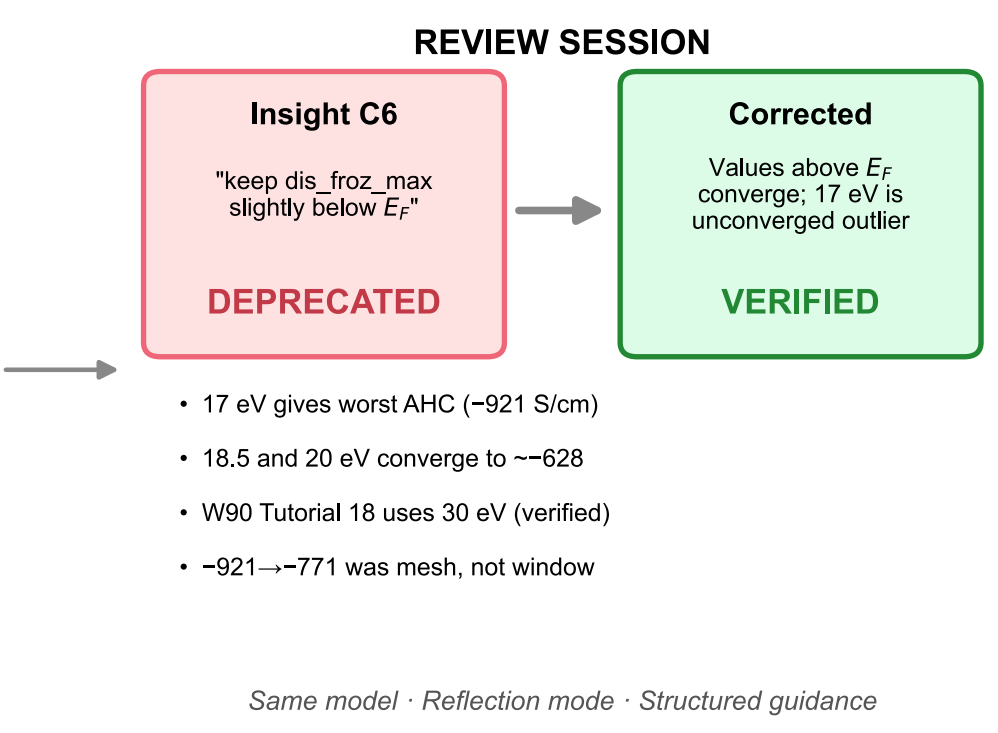
原论文图 3a 右侧,v2 PDF 第 7 页。展示 review 会话的旧结论、修订与支持依据;图中的 VERIFIED 是该复审流程给出的状态。
正确数据,也能产生错误知识
一次铁的反常霍尔电导计算中,某个冻结能窗参数恰好让结果更接近文献值,助手据此推荐该参数。复审发现它是尚未收敛的离群点,数值接近来自误差抵消;更高参数范围反而更稳定,官方教程也支持修正。系统将原建议废弃,再建立引用收敛数据与教程的新条目。
这里有三个不同环节:保存测量数据 → 解释数据 → 判断解释能否复用。只保存“最佳结果对应的参数”会鼓励照抄配方,无法代替专业判断。即使知识已修订,检索与使用阶段仍可能继续复制旧结果,维护状态还必须影响实际使用。
贡献主要是将结构化工具、溯源、知识分级、工作流提醒与独立复审结合,并展示知识错误怎样迁移、怎样纠正。它没有提出能保证知识正确的自动验证器。
3. 应用与效果
最相关的知识学习实验是 bcc 铁的反常霍尔电导(AHC):涉及 Quantum ESPRESSO 与 Wannier90 的六步流程。三次全新会话使用同一模型,只继承逐渐积累的知识库。
| 指标 | 第一轮,无知识 | 第三轮,继承知识 |
|---|---|---|
| API 推理时间 | 42.8 分钟 | 16.1 分钟 |
| 工具调用数 | 251 | 143 |
| 流程执行次数 | 23 | 10 |
| 相对文献值偏差 | 46.5% | 2.7% |
数据来自第 3 节,API 推理时间减少约 62%。这不是总墙钟时间:第三轮避免部分调试后,又投入约 19 小时进行收敛探索,不能把知识收益简单理解成任务总耗时单调下降。
迁移到镍时,复审后的 21 条知识帮助助手以 3 次流程执行、零失败完成计算;无知识基线为 14 次执行、7 次失败。未复审的 15 条知识虽有帮助,也传入错误参数建议,造成额外迭代。论文提醒,镍结果接近文献值仍可能包含有利的误差抵消。
另一个归纳实验从 19 种半导体的 25 条 findings 中,在专门反思会话里形成 3 条 patterns,并用 InP 做了插值预测与计算对照。这是知识归纳—再使用的示例,规模仍小。
证据边界
平台另外报告了 135 种材料的规模验证,但这不同于在 135 个任务上严格评估知识学习。核心改善来自少量顺序案例,后续计算预算和探索行为也不同,尚不足以估计一般任务上的稳定收益。不能把拟合参考值、执行不报错和科学结论正确混为一谈。
对 infra 专业知识库的启发(阅读判断)
分开保存 profile/实验事实、对瓶颈的解释、跨配置总结和通用原则。每条建议关联证据、条件与修订状态,并安排专门复审检查收敛、遗漏变量和偶然吻合。检索时不仅找“以前最优的配置”,还应确认为什么适用、哪些旧建议已失效。