Language Models as AI Research World Models
核心思路
AI 研究 agent 提出实验想法很便宜,真正跑实验却很贵。论文把 LLM 当作“研究世界模型”(RWM):给定研究环境和一个候选改动,在执行前预测它能带来多少收益,只把预算花在最有希望的候选上。实验发现,把过去真实实验的记录放进上下文,预测会明显变准;这些经验还能跨环境复用,且增加实验记录比换更强的模型或提高推理强度更有效。
1. 背景与问题
Autoresearch、AI Scientist 等研究 agent 把“提出 → 实现 → 评估”自动化了。瓶颈随之转移:候选干预(intervention)越来越多,可执行的实验预算有限。同一个改动,例如换学习率调度或数据配比,在一个模型和预算下有效,换一个环境可能无效甚至有害。
所以需要一种能力:执行之前预测某个改动在某个环境中的效果。这一视角借自强化学习中的世界模型:
| 世界模型 | 研究世界模型 |
|---|---|
| 状态 / 环境 | 研究环境:参考模型、数据、配置、预算、评测方式 |
| 动作 | 干预:相对参考代码或配方的一处或多处可执行改动 |
| 预测后果 | 执行后的收益(gain) |
论文要回答的核心问题是:在一个环境中积累的实验经验,能否帮助预测另一个环境中的结果?
2. 方法与创新
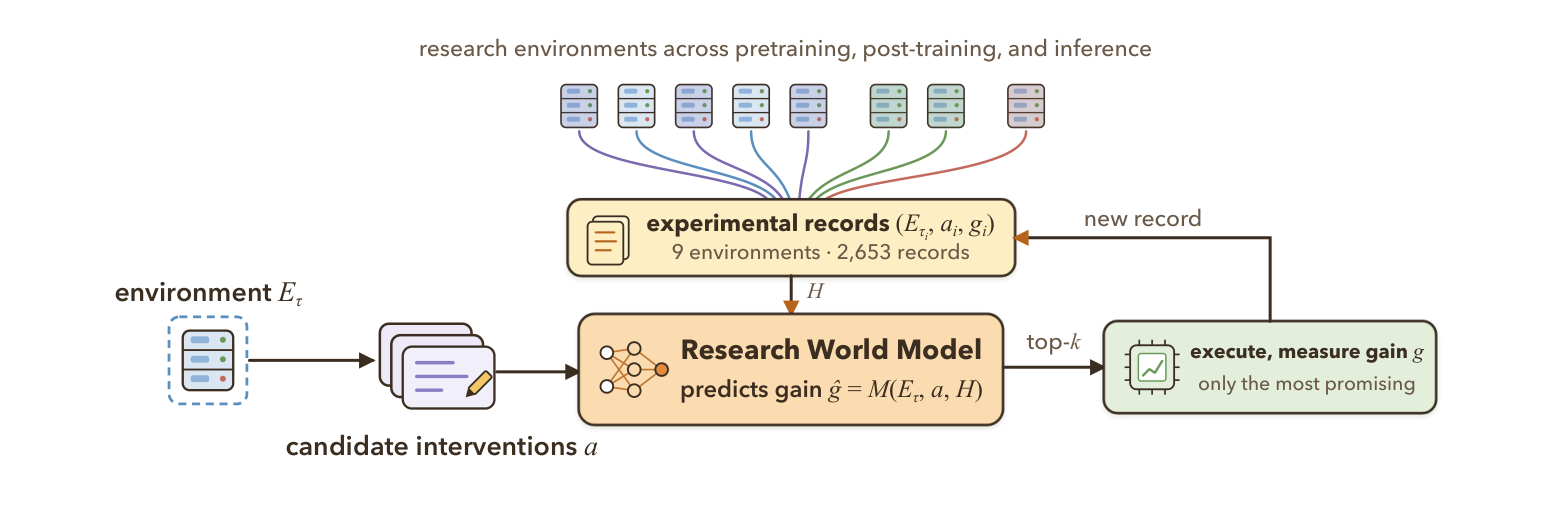
原论文图 1,v1 PDF 第 2 页。各环境的实验记录构成历史 ;RWM 为候选干预打分,只执行 top-k,测得的收益再写回记录。
形式化
研究任务 定义环境 。选择干预 后执行完整实验,得到终止状态(如模型 checkpoint),再读出相对参考的收益:
收益统一取“越大越好”:BPB 用参考值减候选值,准确率和吞吐用候选值减参考值。RWM 预测收益分布的中位数:
把任务描述、具体干预和允许使用的历史记录序列化为文本;LLM 参数 不变,经验完全通过上下文学习获得。历史是三元组 ,分三种条件:
| 条件 | 历史记录 | 回答的问题 |
|---|---|---|
| 无() | 只靠预训练知识能预测多准 | |
| 全部来自目标环境 | 能否从同环境经验中学习 | |
| 全部来自其他环境 | 经验能否迁移到没有任何本地记录的环境 |
跨环境评测会把被测干预及其近似重复组从源记录中剔除,防止直接“抄答案”。
数据:真实实验记录
| 阶段 | 环境 | 指标 | 记录数 |
|---|---|---|---|
| 预训练 | OLMo3-100M、OLMo3-190M、Marin、Qwen3、Nanochat(约 100M–190M 参数的小模型) | 十项任务平均 BPB | 480 + 4 × 132 |
| 预训练 | 扩散语言模型 E2D2-170M | DUEL BPB | 661 |
| 后训练 | Qwen3-1.7B 数学自蒸馏;OLMo-3-7B 代码 RL | AIME avg@32;LiveCodeBench | 280;149 |
| 推理 | Gemma-4-E4B-it + vLLM | 满足困惑度约束的吞吐 | 555 |
共 9 个环境、2,653 条记录,耗费 171,862 H100 GPU 小时。每条记录保存环境、干预(代码 diff 或配置覆盖)、结果与元数据(执行状态、随机种子)。默认 RWM 底座是 Claude Opus 5(1M 上下文、HIGH 推理强度);对照为基于 TF-IDF 特征、使用相同记录的 kNN 和岭回归。
3. 应用与效果
预测准确度
| 设置 | Spearman:无经验 → 有经验 | 补充 |
|---|---|---|
| 同环境(5 个环境平均) | 0.506 → 0.774 | 五个环境都提升,且都优于 kNN 与岭回归;如推理优化 0.54 → 0.88 |
| 跨环境(5 个自回归预训练环境,宏平均) | 0.63 → 0.73 | kNN 只有 0.36、岭回归 0.25,反而低于无经验的 LLM |
跨环境时,kNN 失效的典型案例是:Nanochat 本来就使用 Muon 优化器;对一个 Muon 变体,kNN 参照其他环境中大多有益的类似改动,预测收益 +0.018 BPB,实测却是 −0.036;无经验的 LLM 预测 −0.035。字面相似的改动,在不同起点上可能是完全不同的修改;LLM 能结合环境理解这一点,基于特征相似度的方法做不到。
实验选择
模拟一轮研究:从 16 个候选中选 3 个执行(约 20% 预算)。Regret@3 是错过的最佳收益,NDCG@3 衡量所选候选的收益与排序。
- 同环境:Regret@3 平均下降 58.2%,NDCG@3 从 0.599 升到 0.785。
- 跨环境:宏平均 Regret@3 下降 52.2%,Marin 以外的目标都改善。仅用 OLMo3、Marin、Nanochat 等其他环境的经验,Qwen3 环境的 regret 下降约 78%。
- 成本:给 16 个候选各打一次分约 6.3 美元,而一次代表性实验约 42.3 H100 GPU 小时(约 127 美元),打分成本约为一次实验的 5%。
多轮 Autoresearch
在 OLMo3-100M 上做 5 次评测,每次 8 轮,每轮新来 16 个候选、选 3 个执行,总预算 24 次。执行结果会继续加入历史。
| 初始经验 | 最终最佳收益(相对 ) | nAULC(以知道答案的 Oracle 为 100%) |
|---|---|---|
| — | 85.26% | |
| (244 条同环境记录) | +15.8% | 98.26% |
| (244 条跨环境记录) | +11.6% | 94.34% |
nAULC 衡量整条“目前最佳收益”曲线下的面积,越早找到好改动越高(数值读自图 2b)。用同样跨环境记录初始化的 kNN 与岭回归不如 。
经验、底座与推理强度
在 OLMo3-100M 上比较:
- 13 个底座模型,无经验时 Spearman 为 −0.362 至 0.621,有经验时为 0.638 至 0.896;最弱的“有经验”模型也超过最强的“无经验”模型。
- 固定 Claude Opus 5,把推理强度从 LOW 提到 MAX,只从 0.609 提到 0.648;保持 LOW 但加入经验,则达到 0.892。
作者据此认为:在测试范围内,缺少相关研究经验比推理不足更是瓶颈,应当系统地积累实验数据,未来再训练专门的 RWM。
证据边界
- 跨环境证据只来自约 100M–190M 参数的自回归预训练环境,迁移到后训练、推理或更大规模尚未检验。
- 每个环境只用一个固定划分;参考模型的种子标准差约 0.005 BPB,与许多干预的收益和 MAE 处于同一量级,单次执行的记录本身含有不小的噪声。
- 多轮实验只在 OLMo3-100M 上做了 5 次;所有干预都相对同一参考,未覆盖改动累积叠加的研究过程。
- 经验通过上下文学习获得,依赖商业 API,结果不能逐位复现;底座模型也可能在预训练中见过 Muon 等公开知识。
对 CKG 的启发(阅读判断)
这篇给“为什么要积累实验知识”提供了直接证据:记录应以“环境(参考配方与条件)+ 具体干预 + 测得收益 + 状态与种子”为单位保存,负结果也要保留。Muon 的例子说明,知识条目必须附带它成立的起点条件,否则跨环境检索会被字面相似误导。评估知识库价值时,可借用本文的对照设计:无记录 / 同环境 / 跨环境,以及 kNN 这类不理解环境的检索基线。
相关:Glia 中的 agent 通过实验迭代机制假设,QMatSuite 讨论把实验沉淀为可复用的专业知识,LLM-DM 中的“世界模型”则是可验证的符号模型。
依据:原文 v1,形式化见第 2 节,环境与数据见第 3.1 节及附录 B,预测与选择结果见第 3.2–3.3 节,多轮实验见第 3.4 节与附录 E,底座与推理强度对比见第 3.5 节,跨环境置信区间见附录 D.1;核对日期:2026-10-28。