Inverse Knowledge Search over Verifiable Reasoning: Synthesizing a Scientific Encyclopedia from a Long Chains-of-Thought Knowledge Base
核心思路
把“问题—推导过程—答案”存成知识单元。查询概念时,不只找它的定义,还查找所有使用该概念的推导,再综合成解释与应用文章。需要谨慎的是:论文主要通过问题检查和跨模型答案一致筛选内容,这不足以验证每个中间步骤。
1. 背景与问题
科学知识既包括结论,也包括结论怎样得到、依赖哪些前提、在其他问题中怎样使用。论文认为教材、百科和普通检索常压缩推导,因此提出:知识库是否应该直接保存可复用的完整推导,而不只保存结论和资料片段?
它将被省略的推导联系称为知识的“dark matter”。这是作者对动机的描述;不能据此认为现有教材和互联网普遍没有推导,或模型生成的解释天然具有更高权威性。
相邻路线与本文的差异是:
| 路线 | 可提供什么 | 本文尝试的变化 |
|---|---|---|
| 百科、教材、传统搜索 | 人工知识及其来源 | 将许多问题中的推导过程直接作为可检索语料。 |
| RAG/Deep Research | 检索资料后组织答案 | 预先构建较完整的问答推导,减少解题时从零补中间联系。 |
| 合成问答与模型蒸馏 | 生成训练或评测材料 | 将生成结果作为持续检索与文章综合的知识库。 |
| 科学知识图谱 | 连接概念、实体和关系 | 主要知识先存于推导文本,再从文章中抽取概念图;图不是形式证明结构。 |
与 Microtheories 对照,前者筛选跨题复用的一般陈述,这篇更倾向保留具体问题的长推导及其上下文。
2. 方法与创新
Socrates:按课程组织问题与推导
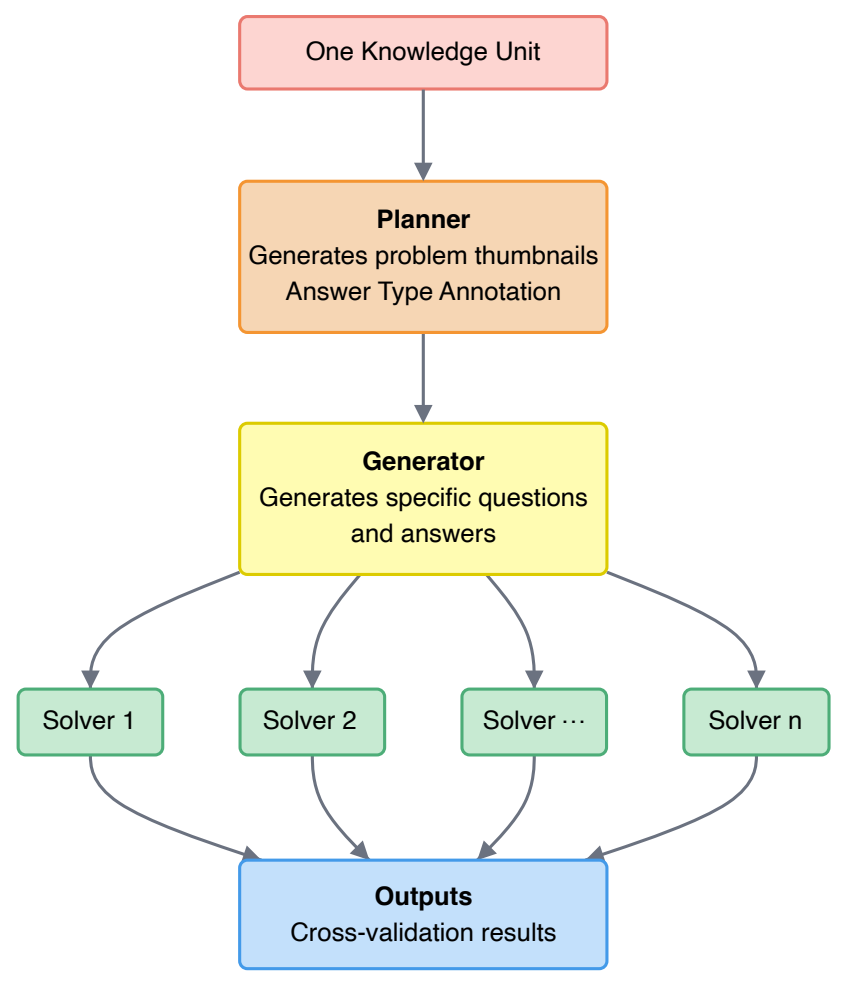
原论文图 1,v3 PDF 第 7 页。这里的交叉检查是内容筛选流程,不能直接解释为形式验证。
基本知识单元是 LCoT-QA:问题、较长的推导文本、最终答案。系统先人工整理约 200 门课程,每门枚举约 200 个主题,再针对主题产生多种问题。
问题生成从目标知识点出发,要求解释或从更基础的原则推导它,称为 endpoint-driven。同一知识点可从中学、本科或研究生层次展开,也包括数值计算、编程与应用题。这是一种覆盖组织策略,不能保证列出的终点已穷尽相关知识。
流程中 Planner 生成问题概要与答案类型,Generator 展开题目,多个 Solver 分别给出答案。模型原有知识被外显成可索引资料,而非通过真实实验重新发现规律。
内容通过哪些检查?
- Prompt sanitization:用另一个模型检查题干是否含错误假设、数值或科学陈述,论文报告过滤约 5% 的生成题。
- 偏向可判定终点:优先生成有数值、符号、代码或选项答案的题目,方便比较。
- Cross-model answer validation:至少两个不同提供方的模型求解;最终答案不一致则丢弃。
这些检查可降低部分明显错误。但不同模型可能共享训练资料和误解;同一终点也可能由错误步骤或错误抵消得到。答案一致是筛选证据,无法自动向后证明整段推导正确。引用论文时应把作者所称的 verified corpus 与实际检查方式一起说明。
Brainstorm:检索概念参与过的推导
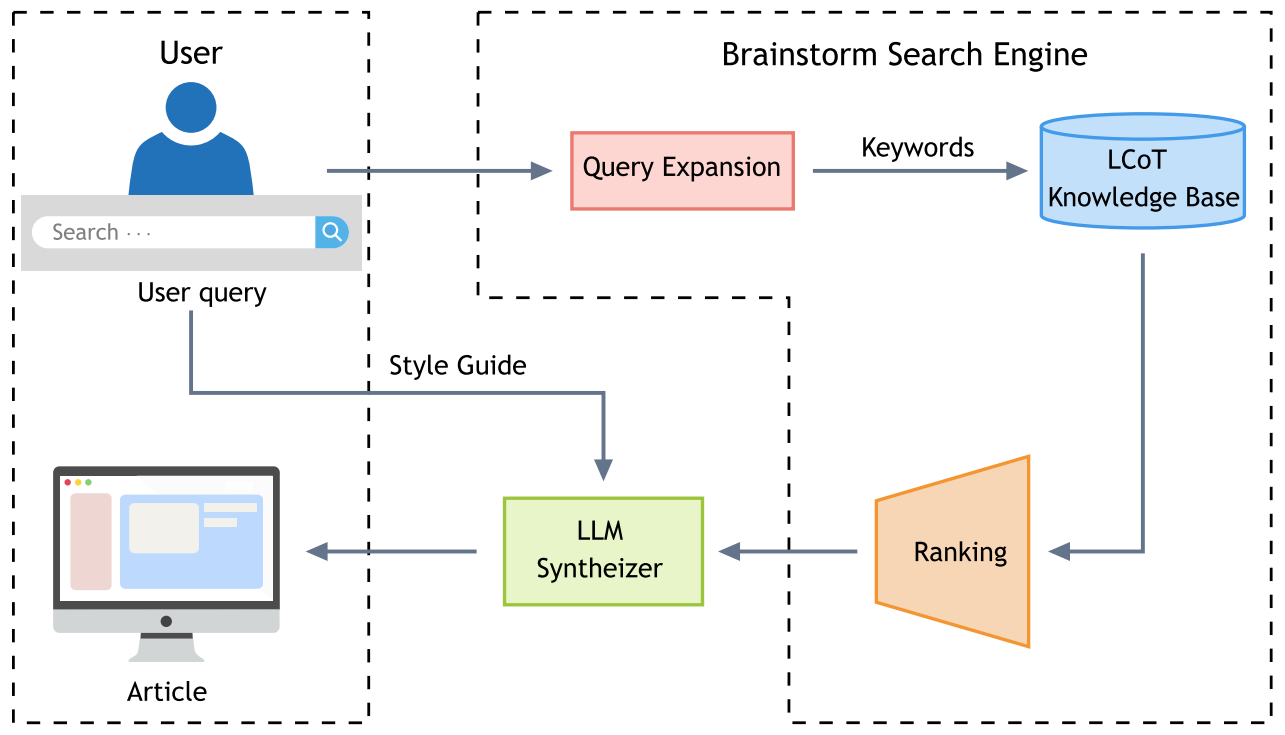
原论文图 2,v3 PDF 第 9 页。检索到的推导作为 Plato 写作的上下文。
用户输入一个概念,查询扩展模块生成关键词,检索包含该概念的推导,再按相关性及跨领域价值排序。这里的 inverse knowledge search 指:从概念回查它在不同问题中的作用和推导语境。
它可以找出“这个概念在什么地方被用到”“不同应用共享哪些前提”,而不只返回定义。这里的 provenance 主要是知识库内部的推导出处;并非每条推导都有独立文献或实验作为外部来源。
Plato/SciencePedia:将推导综合为百科文章
Plato 将检索结果分为“原理与机制”和“应用”等组,结合风格要求写成文章。课程主题及提取关键词提供页面组织,生成文章中的关键词引用进一步形成有向概念图,再进行社区层级分析。
文章综合与图聚类服务于组织和浏览。一个概念被两篇文章共同提及,说明文本有联系,不足以证明两者存在新的科学机制或可靠的因果依赖。
主要增量是推导型知识单元、按课程系统生成、按概念反向检索,以及基于推导的内容综合。检索、长推理生成和多模型一致检查分别已有前序方法;这些环节的组合仍需独立的可靠性评估。
3. 应用与效果
主要应用是生成解释型科学百科,以及支持概念的跨领域探索。例如查询 instanton 时,作者展示从量子隧穿相关推导延伸到粒子物理、宇宙学等语境;其价值在于展示概念在哪里发挥作用,而不只是查一条定义。
论文在六个科学学科上比较有无检索推导上下文的文章生成:尽量保持生成提示一致,Plato 额外获得 LCoT 资料。作者报告知识点密度更高,事实错误率约降低 50%(第 4 节、图 3)。
怎样理解这项效果?
图 3 的事实错误评估由 GPT-5 完成,主要任务是百科文章生成;它不等于独立专家逐步核查,也不是工程推导或代码实现的正确率测试。论文关于知识“高可靠”“全面覆盖”的表述,强于当前验证流程可以保证的程度。
系统还构建了包含 120,226 个关键词节点的图,并观察到多层社区结构。该结果支持内容规模和概念组织能力,不能单独支持知识真实或跨领域推理正确。
对工程知识可以怎样设想?(阅读示意)
查询“算术强度”时,可以同时找到矩阵乘性能分析、roofline 约束与通信规避算法中的不同推导。保留这些推导的输入、假设、单位和中间式,比只保存一句定义更有用。这个 infra 例子用于说明可能的知识组织方式,不是论文完成的实验。
方法还受基础模型的已有知识和错误模式限制。论文将进一步处理教材与论文、补入新研究列为扩展方向;不能把这些未来资料接入能力当成已完成的结果。
对 infra 专业知识库的启发(阅读判断)
可以保存“问题+前提+推导+结论+检查记录”,让同一个概念成为多条推导的入口。验证上则需补充单位/形状检查、可执行计算、独立文献和实测依据,并区分终点核对与每一步有效性。值得借鉴的是知识单元和检索方式,其强验证主张应保留判断。