CAMEO: A Causal Transfer Learning Approach for Performance Optimization of Configurable Computer Systems
核心思路
系统换了硬件、负载、软件或部署拓扑后,原环境(source,如测试环境)中的最优配置往往不再最优,而在新环境(target,如生产环境)中做实验很贵。CAMEO 迁移的不是最优配置,也不是相关性模型,而是跨环境不变的因果结构:先从源环境数据学出因果性能模型,只保留对性能因果效应最强的那几个节点周围的局部结构(Markov blanket),剪掉源环境特有的边;再用少量目标环境样本学一张新图。两张图各训练一个因果高斯过程(warm 与 cold),由组合的采集函数决定下一个测哪个配置,测完再同时更新两张图。
1. 背景与问题
可配置系统的选项横跨硬件(CPU/GPU 频率、核数)、操作系统(swappiness、dirty ratio 等内核参数)、框架(内存增长、并行线程数)和应用本身,组合空间巨大,彼此还有交互。论文把“环境”定义为硬件、负载、软件、部署拓扑的组合;环境一变,最优配置就会移位,例如 MLPerf 目标检测在 Jetson TX2 上的最优配置,换到 Xavier 上就不是最优的。
实际部署中,开发者通常在便宜的 staging 环境里做大量测量,希望把经验带到生产环境。已有做法各有缺陷:
| 做法 | 迁移了什么 | 问题 |
|---|---|---|
| 从零开始的 BO(SMAC、cello) | 什么都不迁移 | 在生产环境需要大量查询 |
| ML 迁移学习(如 ResTune 的元学习集成) | 源环境上训练的统计模型 | 会学到虚假相关,分布一变就失效 |
| 直接复用源因果模型(Unicorn) | 整张源因果图 | 源环境特有的边会带偏目标环境,必须再花预算“去学习” |
动机实验:相关性会反转,因果关系不会
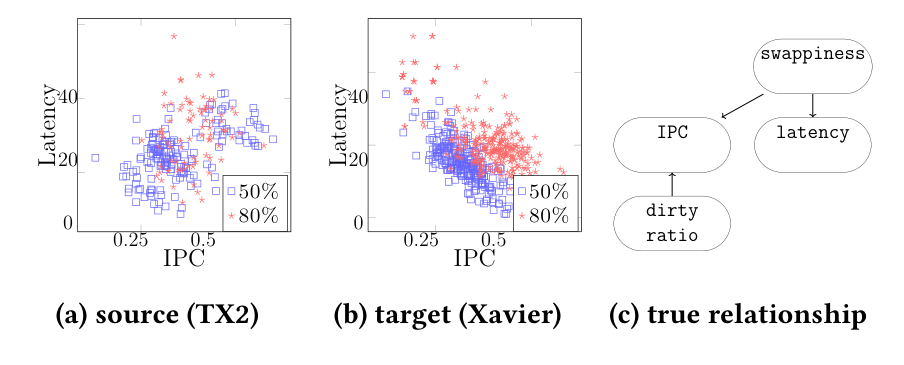
原论文图 2,v2 PDF 第 3 页。颜色区分 swappiness 取 50% 与 80%。(a) 源环境 TX2 中 IPC 与延迟正相关,(b) 目标环境 Xavier 中负相关;(c) 是真实因果结构。
作者只调 swappiness 和 dirty ratio,其余选项保持默认:
- 观测数据显示,源环境中“IPC 越高,延迟越高”,目标环境中却反过来。若模型据此“降低 IPC 来降延迟”,换环境后会适得其反。
- 真实结构是:swappiness 同时影响 IPC 和延迟(共同原因),dirty ratio 也影响 IPC。IPC 与延迟之间没有因果边,二者的相关只是由共同原因造成的。
- 反转的原因:源设备内存只有目标的 1/4,脏页很快填满、被迫写回,IPC 升高却没有实质进展,延迟反而增加;目标设备内存大,脏页不易满,相关方向随之改变。
- “swappiness 越大,延迟越高”在两个环境中都成立,这才是可以迁移的不变关系。
用 TX2 数据训练、在别的设备上预测:GPR 误差 22.4%–27.6%,随机森林 23.2%–25.6%,因果 GPR(CGPR)约 11%,且分布差异增大时依然稳定。
第二个观察:分别在两个环境学因果图,两张图都很稀疏,大部分边是共有的,少数边为源环境或目标环境所独有。所以源图值得复用,但不能整张照搬:源环境特有的边要去掉,目标环境特有的边要用少量目标样本补上。
2. 方法与创新
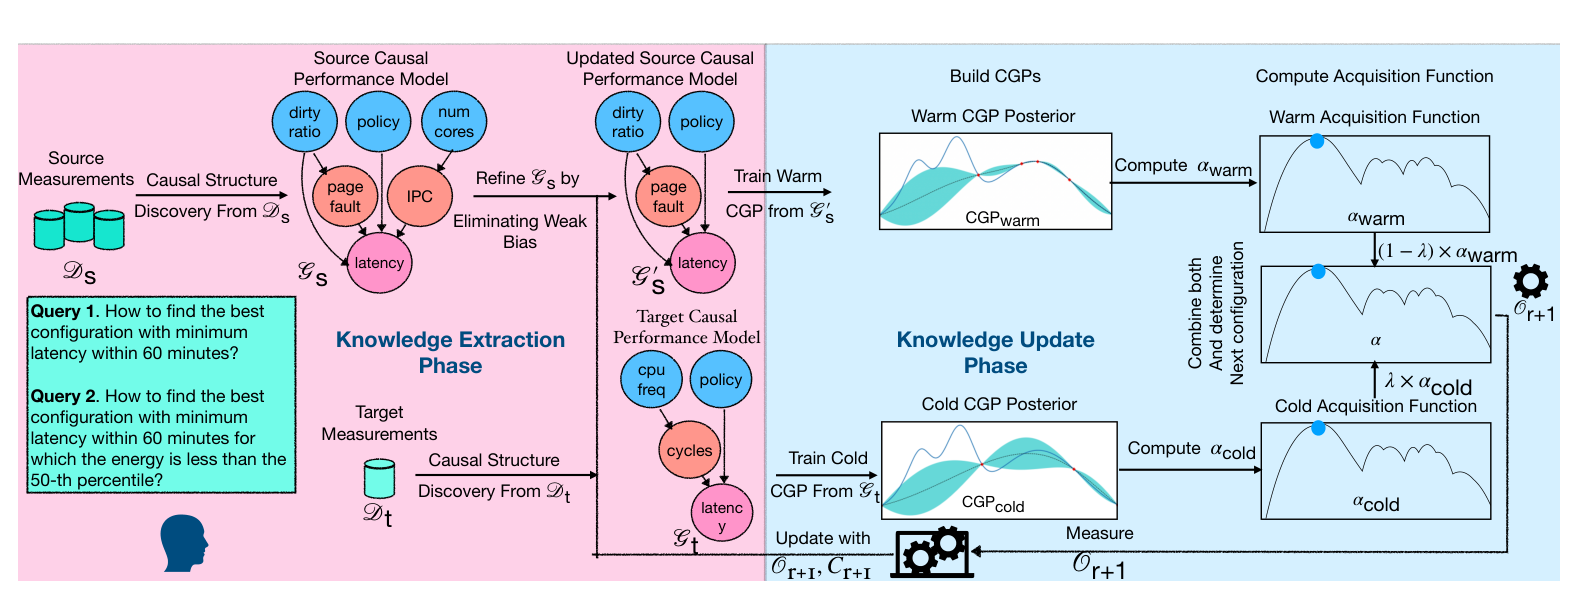
原论文图 6,v2 PDF 第 6 页。左侧(知识抽取)从源数据学 并剪枝为 ,从少量目标数据学 ;右侧(知识更新)分别训练 warm/cold 两个因果高斯过程,组合两者的采集函数选出下一个配置,测量后回写两张图。
问题。 配置选项 与系统事件、性能计数器 (缓存缺失、上下文切换、缺页等,由 perf 采集)合成变量 ,性能目标为 (延迟、能耗、吞吐)。源环境已有 条离线测量 ,目标环境先随机测 条得到 。要在目标环境预算 内找到
用户的请求经一个查询引擎(按固定关键词模板)解析成预算 、约束 和目标 ,例如“45 分钟内找能耗最低、且延迟低于 20 秒的配置”。
第一步:学两张因果性能模型
因果性能模型是一张有向无环混合图(ADMG),节点是配置选项、系统事件和性能指标。 从 学出, 从 学出,结构发现都用 FCI:
- 从全连接无向图开始;
- 用条件独立性检验删边(连续变量用 Fisher z 检验,离散变量用互信息);
- 按定向规则给边定向,得到部分祖先图(PAG);
- PAG 中仍有方向未定的边,用基于熵的 LatentSearch 算法自动定向,最终得到 ADMG。
选 FCI 的原因:系统栈中的变量类型混杂(名义、序数、连续),而且允许存在未观测的混杂因素。我们并不掌握完整的配置空间,总有无法干预的选项或没有采集到的事件。
第二步:剪枝源图,只迁移“核心”
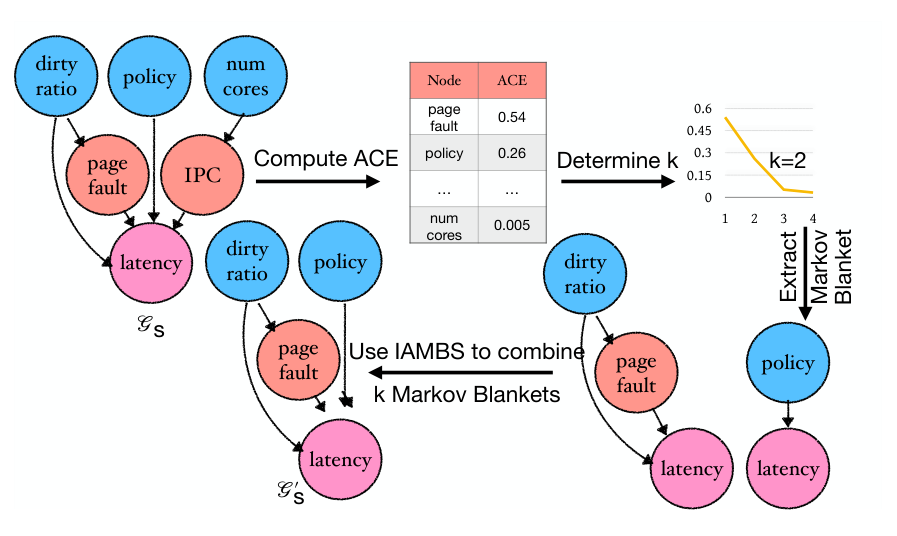
原论文图 7,v2 PDF 第 7 页。计算各节点对延迟的平均因果效应(ACE)→ 确定 k → 提取前 k 个节点的 Markov blanket → 用 IAMBS 合并,得到 。
整张 照搬会把源环境特有的边一起带过去。逐条边做干预来核实又太贵,所以 CAMEO 换了思路:只保留对目标影响最大的那几个节点的局部结构。
- 计算每个节点对性能目标的**平均因果效应(ACE)**并排序;
- 用自动选择聚类数的方法(G-means)确定 ;
- 取前 个节点的 Markov blanket(父节点、子节点、子节点的其他父节点),即预测该节点所需的最小充分特征集;
- 多个节点的 Markov blanket 不一定能简单相加,用 IAMBS 算法通过“增长 + 收缩”两阶段的条件独立性检验合并,得到 。
图 7 的例子:ACE 中缺页 0.54、调度策略 0.26,核数只有 0.005,于是 。保留 dirty ratio → 缺页 → 延迟 和 策略 → 延迟,IPC 与核数被剪掉。第 2 节的完整实验中,取 恰好去掉了两条源环境特有的错误边(migrations → syscalls、migrations → LLC stores),找到最优配置的速度快了 19%。这些弱效应节点上的错误边,只是“效应小”,并不会被单独核实。
第三步:两个因果高斯过程
普通 GP 只能拟合观测到的“配置 → 性能”。因果高斯过程(CGP,来自 Causal BO)用干预分布作均值:
依据因果图用 do-calculus 从数据中估计, 是干预分布的标准差估计。这样在没有观测数据的区域,模型也能借助因果结构给出合理的均值和不确定度。图还决定了探索集:只在对目标有因果影响的变量上考虑干预,因果图越稀疏,候选越少。
| 代理模型 | 用的图 | 用的数据 | 搜索空间 | 角色 |
|---|---|---|---|---|
| 剪枝后的源图 | 源环境测量 | 缩减后的空间 | 提供源环境的先验地图 | |
| 目标图 | 目标环境测量 | 完整空间 | 防止漏掉源图里没有的东西 |
第四步:组合采集函数
两个 CGP 各算一个期望改进(EI): 与 。组合方式是一个按配置切换的开关:
直观理解:源环境的知识(warm)负责粗定位,看哪里可能有好配置;在 warm 认为接近最优的区域内(与其最优采集值相差不超过 ),改用目标环境的知识(cold)精细挑选。实现上就是“先按 排序,再在前列中选 最高的”。 取 0.1 时效果最好(相对误差 10.5%),取 0.05–0.75 中的其他值时为 11.7%–14.3%。
第五步:观察还是干预
沿用 Causal BO 的 -贪心规则,每一轮先决定是“观察”还是“干预”:
是已观测数据的凸包, 是当前数据量, 是愿意收集的最大观测数。抽 : 就做一次观察,否则按组合采集函数选配置去干预。观测数据覆盖的范围越小,干预的需要就越大:只有干预才能估计观测范围之外的因果效应。反过来,覆盖范围足够大时,多做观察能让因果效应的估计更稳定。
第六步:约束与回写
测量选中的配置。若违反约束 ,就把它的目标值记为 ,让优化器远离不可行区域。然后用新数据同时更新 、、两个 CGP 和两份数据集,直到预算用完或收敛,最后返回最优配置。
把一轮循环串起来:
源数据 D_s ──FCI──▶ G_s ──ACE 排序 + top-k Markov blanket──▶ G_s'  ──▶ CGP_warm
目标少量样本 D_t ──FCI──▶ G_t ─────────────────────────────────────▶ CGP_cold
                                                                     │
       ε > u ? ──是──▶ 观察                                          ▼
              └─否──▶ 干预:α = λ·α_cold + (1−λ)·α_warm,选 argmax
                                 │
                       测量 o_{r+1} 及其系统事件;违反约束则记 y = ∞
                                 │
                       回写 D_s / D_t,更新 G_s、G_t 与两个 CGP ──▶ 下一轮
与前作的区别
CAMEO 是 Unicorn 同一组作者的后续工作,建立在多任务 BO(JUMBO 的 warm/cold 双 GP 结构)与 Causal BO(CGP 和观察–干预权衡)之上。和 Unicorn 相比,关键差别是:不直接复用整张源图,而是剪枝后迁移,并另外维护一张目标图,因此省掉了“先学进来再去学习”的预算。
论文没讲清的
- “观察”在配置调优场景中具体指什么(不设定配置、被动采样?),论文没有说明,只沿用了 CBO 的说法。
- 采集函数的符号前后不一:正文说选 最大的配置,算法 1 写的却是 argmin;正文对 规则的文字解释也与公式不完全吻合。
- ACE 用哪张图、哪些数据估计, 的选择细节,探索集如何构造,都只给了引用。
- 每轮都“更新 、”,是否意味着重新跑 FCI 和 Markov blanket 提取,开销如何,没有交代。
3. 应用与效果
评测覆盖 5 个系统:MLPerf 目标检测、NLP(BERT)、语音识别(DeepSpeech)、DeepStream 视频分析和 Cassandra 数据库。部署在 Jetson TX1/TX2/Xavier/Xavier NX 和 Chameleon 云上,覆盖硬件、软件、负载、部署拓扑四类环境变化。每种方法预算 200 次迭代、3 个随机种子。以 2,000 个随机配置中的最好值作为“最优”,计算相对误差(RE)。
| 方法 | 延迟 RE(%) | 能耗 RE(%) |
|---|---|---|
| SMAC | 88.2 | 268.9 |
| cello | 46.2 | 182.5 |
| Unicorn | 55.5 | 179.9 |
| ResTune | 29.2 | 81.2 |
| CAMEO | 7.8 | 14.4 |
- 唯一落后的场景是 Cassandra 从“只读”变到“读写各半”:两种负载分布相近,ResTune 的吞吐高 2%;换成“写为主”时,CAMEO 反超。
- 环境变化越剧烈,CAMEO 领先 ResTune 越多:低、中、高三档分别为 1.3×、1.5×、1.9× 吞吐。
- 合并两张图后学到的结构,与目标环境“真值”因果图的 Hamming 距离明显小于只用其中一张;变量从 4 增到 100 时,结构发现与每轮耗时都呈次线性增长。代价是每轮计算比基线慢一些,但相对单次测量(平均 44 秒)不算多。
证据边界
- 摘要与引言中的“延迟降低 3.7×、能耗降低 5.6×”,实际是相对误差之比(29.2/7.8、81.2/14.4),不是延迟或能耗本身降低了这么多。
- “最优值”取自 2,000 个随机配置中的最好者;RE 取绝对值,若找到比它更好的配置也会被算作误差。只有 3 个种子,表中没有方差。
- 文中多处前后不一:动机实验说源环境是 TX2,附录图 19 写的却是 Xavier;模型一处写 ResNet-50,一处写 ResNet-18;Cassandra 负载一处说 TPC-C,一处说 YCSB;局限一节说每轮 27.1 s 对比 ResTune 的 19.4 s,表 5 中却是 71.6 s 对比 63.4 s;附录表 16 中,带能耗约束的延迟优化在软件变化场景下 CAMEO(22.5%)不如 cello(17.1%),正文却说“一致优于”。
- 因果发现本身是 NP 难问题,用几百个样本学到的图未必正确;用来算 Hamming 距离的“真值图”如何得到也没有说明。多数内核选项只有 2–4 个离散取值。
- 作者与基线 Unicorn 是同一组。
对 CKG 的启发(阅读判断)
这篇给知识迁移提了两条很实用的规则。其一,迁移结构而不是结论:最优配置和相关性都会随环境改变,因果结构大部分不变;IPC 与延迟的例子说明,相关性条目绝不能当因果断言入库。其二,只迁移最有把握的局部:按因果效应排序,只保留前 k 个节点的 Markov blanket,效应弱的部分宁可在新环境里重学。图 3 的“共有边 / 源独有边 / 目标独有边”分类,也提示每条因果边都应带上它被观测到的环境范围;源知识与目标知识要分开维护、组合使用,而不是互相覆盖。
相关:Unicorn 是同组前作,CAMEO 在它“整图复用”的基础上改为剪枝迁移;Koi 同样用不变因果预测处理跨任务的机制证据;GPTuner 用文档知识缩小调参空间;RWM 讨论实验经验何时能跨环境迁移。
依据:原文 v2,动机实验见第 2 节,问题与框架见第 3.1–3.2 节,结构发现与剪枝见第 3.3 节,CGP、采集函数与观察–干预权衡见第 3.4 节及算法 1,实验见第 4–7 节,局限见第 9 节,约束优化见附录表 16;核对日期:2026-11-01。