Rosetta: Automating First-Principles Performance Modeling Using Multi-Agent LLMs
核心思路
体系结构论文很少附带解析性能模型,因为手工推导要花专家数周。Rosetta 只输入一篇论文 PDF,由多个 LLM agent 自动产出三件东西:数学规格说明(SPECIFICATION.md)、可执行的 Python 模型(model.py)和白话解读(INTERPRETATION.md)。核心约束是从第一性原理推导:性能必须由硬件参数算出,论文报告的结果只能作为叠加在图上的校准点,二者之间无法解释的差距称为 “magic gap”。作者发现,最有价值的并不是数值预测,而是形式化过程本身:它会逼出隐含假设、列出缺失参数。
1. 背景与问题
解析性能模型从硬件参数和负载特征推出吞吐、延迟、能耗或加速比,能说明性能上限从何而来、哪个参数是瓶颈、条件变化后结论如何。它让读者无需作者的模拟器就能独立核验论断,工业界也能借此分享结论而不暴露专有基础设施。但手工建模需要数周时间、数学功底和对负载与硬件的直觉,所以大多数论文只给模拟或实测结果。
Rosetta 做的相当于审稿人的“反算”:论文说加速 9 倍,按它描述的硬件,物理上最多能快多少?任务定义为:给定论文 PDF ,产出
- 规格 :基线与新方案的硬件参数、负载模型和代价函数,不得把报告结果当输入;
- 实现 的可执行模型 ;
- 解读 :报告模型的发现,包括 的第一性原理预测与论文报告结果之间的量化差距。
让 LLM 直接做这件事,会遇到四种失败,各有一项设计应对:
| 失败模式 | 对策 |
|---|---|
| 循环推理:把论文报告值当输入,再“验证”论文 | 科学宪法 PRIME DIRECTIVE |
| 单次生成的规格质量低 | 带独立批评 agent 的“验证–修复”循环 |
| 代码忠实实现了一份在科学上错误的规格 | 双重验证:功能正确性与科学有效性分开审 |
| LLM 输出随机 | best-of-N 集成 |
2. 方法与创新
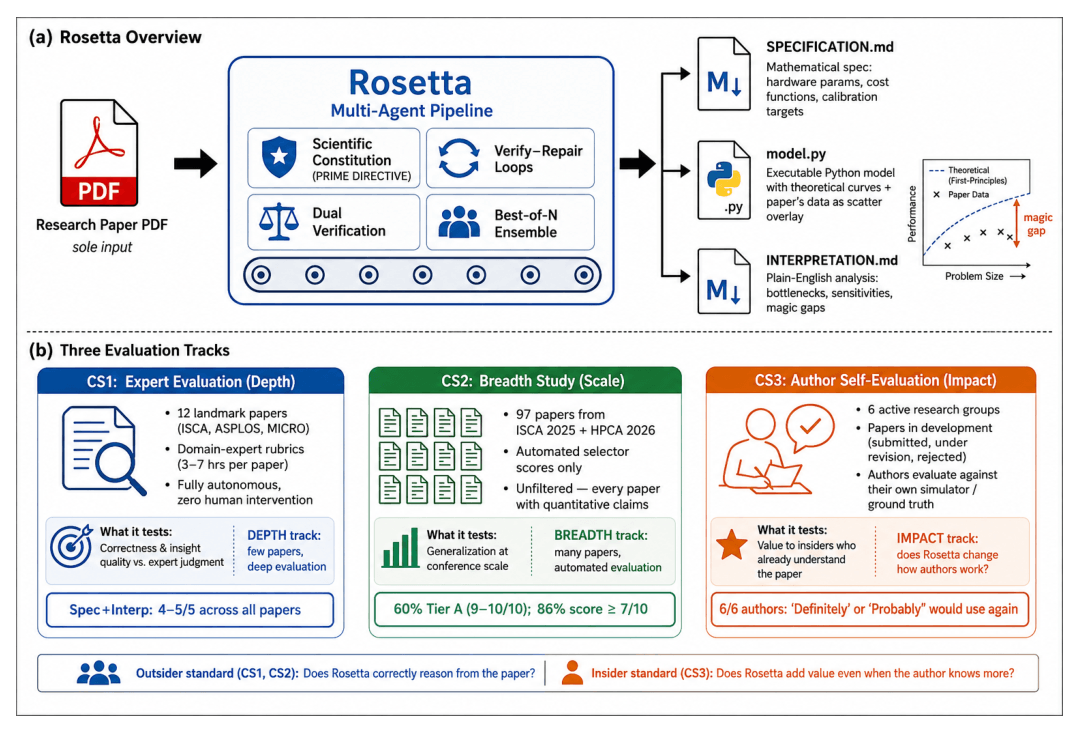
原论文图 1,v1 PDF 第 1 页。a 是输入一篇 PDF、输出三份产物的总览,右侧示意理论曲线与论文数据点之间的 magic gap;b 是三条评估线 CS1–CS3。
核心原则:结果只用来比,不用来算
LLM 最自然的做法是拿论文的数字去推论文的数字。论文附的反例和正例:
# 禁止:用论文"验证"论文
per_vcu = paper_reported_20vcu / 20       # 论文报告的 20 单元吞吐
throughput_8vcu = per_vcu * 8             # 再乘回去,必然吻合

# 要求:从硬件参数推出来
mpix_per_core   = pixels * fps / 1e6                  # 来自论文 3.1 节
compute_bound   = mpix_per_core * cores_per_vcu
theoretical_max = min(compute_bound, memory_bound)
efficiency = paper_claimed / theoretical_max # → 差了 15%论文报告值只作为校准点,以红叉画在理论曲线上,与独立推导的结果并排比较:
| 红叉位置 | 含义 |
|---|---|
| 落在曲线附近 | 论文结果能被它描述的机制解释 |
| 高于理论曲线 | 声称的性能超出描述的机制所能支撑的范围,即 magic gap:可能有未写明的假设或未提到的优化 |
| 远低于曲线 | 说法偏保守,或者存在没建模的损耗 |
论文常常不给全部参数。这时 Rosetta 不拟合、不编数,而是对缺失参数扫描一个合理区间,或者给出上下界;同时把估计明确标成“校准模式”,并列出缺了哪些参数。这本身就是一种有效输出。
三阶段流水线
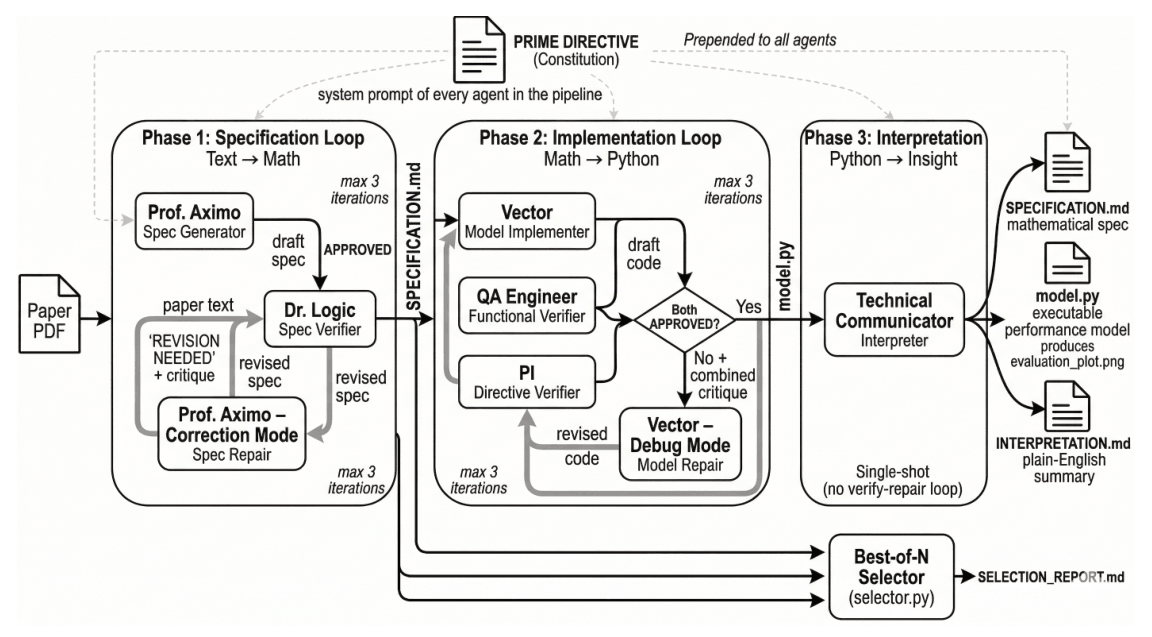
原论文图 2,v1 PDF 第 3 页。阶段 1、2 各有最多三轮的验证–修复循环;整条流水线跑 N=3 次,由选择器 agent 挑出最好的一次。
| 阶段 | 生成者 | 验证者 | 产物 |
|---|---|---|---|
| 1 规格(文本 → 数学) | Prof. Aximo:“只信变量、方程和具体数据点”的建模专家 | Dr. Logic:对照原文和宪法审查 | 硬件参数(Python 变量名、取值范围、出处章节)、负载模型、基线与新方案的代价函数、校准目标 (input_state, claimed_output, source)、初始 magic gap 假设 |
| 2 实现(数学 → Python) | Vector:数据科学家兼模拟工程师 | QA Engineer 与 PI,两者都批准才通过 | Config 数据类、cost_baseline() / cost_proposed()、参数扫描、固定样式的图(基线虚线、新方案实线、论文数据红叉);保存前用 ast.parse() 检查语法 |
| 3 解读(Python → 洞见) | Technical Communicator | 无 | 模型假设的负载、基线与新机制、关键变量与胜负阈值、理论曲线与论文结果的差距 |
为什么先写规格再写代码? 规格是人能审的中间层。直接写代码,错误会藏在实现细节里;先把“用了哪些变量、什么公式、参数出自哪里”写成数学文档,审查者才能对照原文逐条核对。
验证者只能回答 APPROVED: <理由> 或 REVISION NEEDED: <详细批评>。被拒后,生成者带着原文、被拒稿和批评进入修正模式,最多三轮。阶段 2 的修复会同时拿到两份批评,从头重写模型。所有草稿和批评都存盘,形成审计轨迹。阶段 3 只生成一次,作者认为解读质量从反复修改中获益不多。
双重验证:忠实不等于正确
代码有两种互不相关的失败方式,所以由两个审查者分别负责:
| 审查者 | 问的问题 | 防的错误 |
|---|---|---|
| QA Engineer | 代码是否忠实于规格?变量名对得上吗?公式抄对了吗?numpy 广播会不会出错? | 实现错误 |
| PI | 在科学上成立吗?有基线对比吗?校准点只作叠加吗?能独立运行吗? | 规格本身的科学错误 |
PI 的检验很具体:“删掉代码里所有来自论文表格和图的数据,它还能算出性能吗?不能,就违反了第一性原理。”
两个真实例子:
- 一份规格把 CraterLake 特有的 CRB 单元安到了 F1+ 基线上,而 F1+ 并没有这个硬件。代码完全照规格写,于是通过了功能审查。这类错误只能靠阶段 1 对照原文审规格来拦。
- Anton 的一次运行功能上忠实于规格,但 PI 发现主计算用的是论文结果表,即违反第一性原理的写法已经在规格里埋下了。
作者观察到,一个审查者同时查两件事时总会偏向其中之一。
科学宪法:给审查者一把统一的尺子
所有 agent 的提示词前面都附上同一份 PRIME DIRECTIVE,共四条:
- 第一性原理推导:从核数、频率、内存带宽等推出性能,禁止缩放或拟合报告数值(附上面的代码反例)。
- 校准只作叠加:报告值只画在图上用于比较。
- 自包含:
python model.py无参数、无外部文件、无网络即可运行,负载数据按规格中的分布自行生成。 - 基线与新方案并列:脱离基线单独分析新方案在科学上没有意义。
宪法的作用是让“审查”有明确标准,而不只是另一个 LLM 的主观意见:Dr. Logic 和 PI 可以指着具体条款判违规。没有宪法时,CraterLake 的一次运行从论文的 11.2× 反推效率,得出了不可能的 465×。
best-of-N 集成
整条流水线对同一篇论文跑 3 次。选择器先执行每个 model.py,跑不起来的直接淘汰,再按三项排序:正确性 > 洞见质量(是否找出具体瓶颈、量化差距、超出复述论文)> 完整性。
三次运行的差异往往在建模思路上,而不只是数值:
- 在 Darwin 论文上,只有一次运行指出“15,000× 加速”只对某一类读段成立,换一类就降到 1,244×。
- Anton 的一次运行预测值比论文高 5–6 倍,解读却宣称“验证成功”,被选择器淘汰。
- NeuRex 上,第 1 次预测 3× 减速,第 2 次崩溃却编出了解读,只有第 3 次推导正确。
第 1、2、3 次运行胜出的比例大致相当,说明是真正独立的抽样。集成也能兜住验证循环漏掉的错误:F1+ 基线的缺陷挺过了三轮规格审查,选择器最终换用了另一次运行。
示例:NeuRex
NeuRex 是神经渲染加速器,声称比边缘 GPU 快 9.17×、比服务器 GPU 快 2.88×。
规格列出参数,每项注明出处:
| 参数 | Xavier NX(边缘) | RTX 3070(服务器) | 出处 |
|---|---|---|---|
| L2 缓存 | 256 KB | 4 MB | 3.4 节、公开规格 |
| 内存带宽 | 51.2 GB/s | 448 GB/s | 公开规格 |
再从原文一句话“每次哈希访问只用到 64 字节中的 4 字节”推出 GPU 的带宽效率:
模型由此给出解释:2 MB 的哈希表装不进边缘 GPU 的 L2,每次查表都要访问主存;服务器 GPU 的 4 MB L2 装得下,问题本来就缓解了一大半。所以边缘端加速比远大于服务器端。GPU 实际利用率 论文没有给出,模型不拟合它,而是在 0.10–0.40 之间扫描得到一条预测带,结果论文的两个加速比都落在带内。
生成的规格 643 行、模型 1,177 行,耗时 30–40 分钟。
实现
共 8 个 agent,其中 6 个是“生成者/验证者”或“生成者/修复者”配对,没有 agent 评审自己的产出。作者据此认为,单 agent 环境(如 Claude Code)会自我确认偏差、做不了正交的双重验证,也用不上抽样多样性。
温度 0.5,底座为 Claude Opus 4.5(作者称 Gemini 和 ChatGPT 系列效果较差)。生成者和验证者的输出预算分别为 16,384 和 8,192 token;超出上下文时,预算每次乘 1.5 重试,上限 64,000。一篇论文的中位耗时为 72 分钟,三次运行并行约 25 分钟。
论文没讲清的
- 选择器如何判断“洞见质量”,没有给出评分细则。
- 校准点要从论文的图中读数,读数精度如何保证,没有说明。
- CS3 中提到的“阅读助手”(提前指出论文问题)不在系统设计章节里,与三阶段流水线的关系不明。
- “去掉宪法会显著变差”只有个例支持,没有消融统计。
3. 应用与效果
全部在完全自主模式下运行:只输入 PDF,无人工干预。
| 评估线 | 做法 | 主要结果 |
|---|---|---|
| CS1 深度 | 12 篇 ISCA/ASPLOS/MICRO 经典论文,跨七个领域,每篇一位评估者花 3–7 小时打分 | 规格与解读 10/12 篇 ≥ 4/5,没有严重幻觉;模型分 2–5;“超出论文的洞见”差异最大 |
| CS2 广度 | ISCA 2025 + HPCA 2026 共 97 篇,由选择器自动打分 | 56% 达 A 档;15% 揭示了读论文看不出的矛盾;每篇约 39 美元 |
| CS3 作者自评 | 6 个研究组用在自己的在投论文上 | 5/6 肯定会再用,4/6 的论文因此改动;全部认为规格文件最有用 |
收益最大的是硬件描述丰富、显式数学稀少、只报告单点结果的论文,例如 CraterLake 的加速比随乘法深度从 4× 变到 51×。在受限的三篇中(参数被隐去、组件分歧、缺少基线),Rosetta 都能指出自己为什么解释不了,而不是给出虚假的自信结论。CS1 的 12 篇及其产物与评分表一起发布为 CAAM-Bench。
证据边界
- 方法本身:审查者只查是否违反宪法,不核对公式是否与原文一致(Anton 的长程力公式错误就从规格一直传进了模型);规格漏掉的东西,代码补不回来。图遍历加速器(GT)的作者认为,失败的根源是 LLM 不理解核心算法与访存模式的交互,补全参数也解决不了。
- CS1 每篇只有一位评估者,且自评领域专长仅 1–3/5;这些论文多半在 Claude Opus 4.5 的训练数据中。
- CS2 由流水线自带的选择器打分,相当于 LLM 自评。数字前后不一:A 档比例有 56% 与 60% 两种说法,扣除 17 篇后应为 80 篇,正文却写 78 篇。
- CS3 只有 6 个自愿参与的研究组,由作者自评,没有对照组。
- 表 II 中 Darwin、Anton、GZKP 的模型分高于规格分,与“模型质量从不高于规格质量”的结论不符。
- 只用了 Claude Opus 4.5。CAAM-Bench 的参考产物本身是 Rosetta 生成的,用它评估后续工具会偏向 Rosetta 的建模方式。
对 CKG 的启发(阅读判断)
最值得借鉴的是“校准只作叠加”:论文报告的结论不能进入推导链,只能与独立推导的结果并排存放,二者的差距(magic gap)本身就是一条需要记录、待解释的知识。规格中每个参数都标注来源章节,缺失参数单列成清单,推不出来时输出上下界或扫描区间并注明原因。生成与验证分离、“忠实于规格”与“规格本身是否科学”分开审,也适用于知识抽取:抽取忠实于原文,不代表原文的推理成立。CS3 的结论提示,对用户最有用的可能是结构化的规格(变量、假设、适用条件),而不是最后的数字。
相关:MLSYSIM 是人工构建的第一性原理系统建模工具,正是 Rosetta 想自动化的那类产物;LLM-DM 同样让 LLM 起草形式化模型、由验证器和人纠错;Simthesizer 的“规格 → 实现映射 → 验证报告”与 Rosetta 的分阶段产物相似。
依据:原文 v1,任务定义见第 II 节,三阶段、宪法与集成见第 III 节,失败案例见第 III-G 节,NeuRex 示例见第 V-B 节,评估见第 IV–VII 节及表 II–III、图 7;核对日期:2026-11-01。