Unicorn: Reasoning about Configurable System Performance through the Lens of Causality
核心思路
在“配置 → 性能”之间保留 cache misses、context switches 等中间机制,学习因果性能模型。用模型挑选值得实测的配置,再根据测量更新模型,服务性能解释、故障修复和优化;换硬件时尝试复用机制并做少量校准。
1. 背景与问题
系统的可配置空间可能极大。直接拟合“配置到时延”的预测器,虽然能在原分布内预测,却难以解释该改哪个参数,也可能在硬件或负载变化时失效。
例如某项配置同时影响吞吐和 cache misses,数据中甚至可能出现 cache misses 越多、吞吐越高。这个相关性不足以推出“故意增加 cache misses 能提高吞吐”。调优需要回答的是主动修改配置会发生什么。
2. 方法与创新
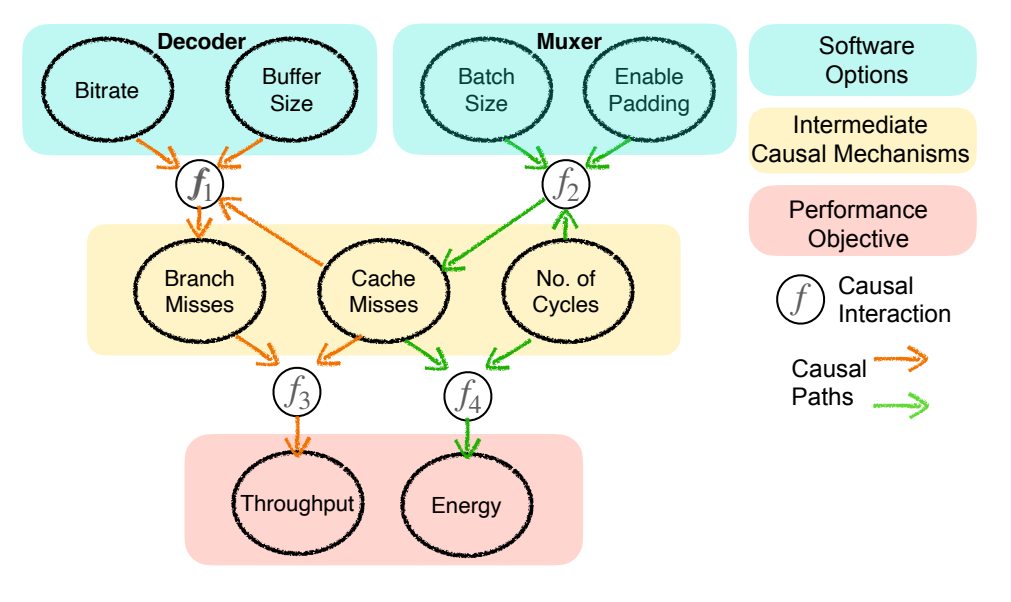
原论文图 6,v2 PDF 第 5 页。上层是可调配置,中层是机制指标,下层是吞吐和能耗;小圆圈表示多变量函数,说明因果关系不一定是一条边乘一个系数。
三类变量,加上函数和结构约束
模型区分:
- 软件与硬件配置,例如 buffer size、batch size、CPU frequency。
- 中间性能事件,例如 branch misses、cache misses、cycles。
- 端到端目标,例如 throughput、latency、energy。
论文用多项式描述函数依赖,也允许其他函数形式。领域约束可限定哪些变量能干预、哪些边不允许出现,降低学习难度。可观察的中间指标不一定能直接控制,这对选择实际修复动作非常重要。
从观测数据学习结构,再解决方向歧义
结构学习采用 FCI,允许存在未观测混杂;结合条件独立检验与领域约束形成 PAG,再使用额外的熵准则处理部分方向歧义,得到供分析使用的图。
这里要区分两层:数据支持哪些关系,以及额外假设怎样选定方向。FCI 的输出不能自动当作已完全识别的 DAG;后续定向仍依赖假设和估计。这也与 CPDAG 论文 所讨论的“保留方向不确定性”形成对照。
用实测闭环更新因果模型
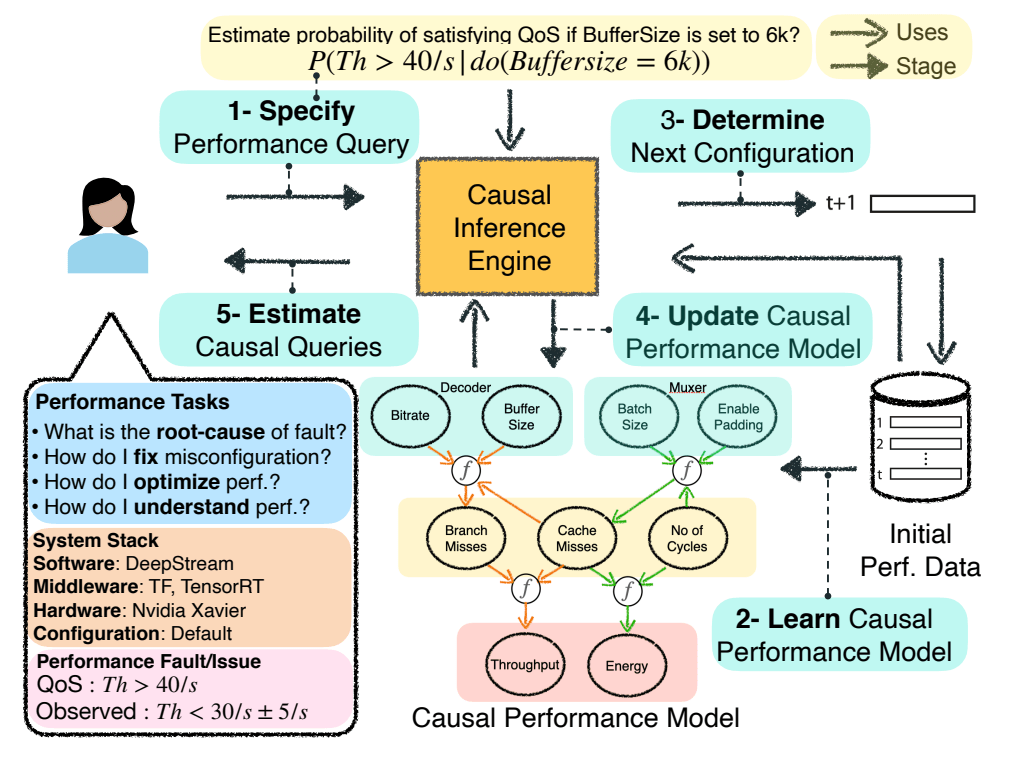
原论文图 7,v2 PDF 第 6 页。关注右侧“下一配置 → 更新模型”这一循环,而不只是最终输出一张图。
先采集配置、系统事件和性能数据,重复测量后用中位数缓解波动。然后从目标向前追溯因果路径,根据估计因果效应排序,优先测量更可能影响目标的配置,持续更新模型直至达到目标或用完预算。
其查询可以是:
这与“历史上 buffer size 为 6000 的样本表现如何”不是同一个问题。推断引擎只对可识别查询给出估计,也可能要求增加假设或测量。用户性能问题到形式化因果查询的翻译,在论文实现中仍由人工完成。
3. 应用与效果
评估包含 DeepStream、Xception、BERT、DeepSpeech、x264、SQLite 六个系统,覆盖性能调试、单目标和多目标优化,以及硬件与负载迁移。
最直观的案例是图 12 与第 5 节:实时场景识别从 TX1 迁到更强的 TX2 后,吞吐从 17 FPS 降到 4 FPS。Unicorn 约 22 分钟给出修复,达到 28 FPS;该实验中的 SMAC 用约 4 小时达到 24 FPS。这里 4→28 是吞吐提升 7 倍,不应写成时延增加。
迁移实验不是“旧模型无需更新就普遍准确”。例如 Xavier→TX2 的能耗调试,旧模型加 25 个新样本后约 20 分钟完成,效果接近从头重建的约 36 分钟。它支持的是:部分机制可复用,少量新测量可以比全部重学更有效。
证据边界
因果结构、函数形式及未观测因素的处理都有假设,有限样本可能学错边或效应。干预模型中的数字不等于每条边都经过独立随机实验验证。迁移结果来自论文测试的系统和平台;软件行为变化或新瓶颈出现时,旧机制仍需重验。
对 CKG 的启发(阅读判断)
中间节点应保存能解释、能测量的机制,同时标出可干预变量。把“结构复用”和“参数复用”分开:硬件变了,路径可能还成立,系数却需要重新拟合。保存每次修复前后的配置、机制指标和端到端结果,才能检验解释是否成立,而不只记录最优参数。
相关:MLSYSIM 从已知公式分析约束;GPTuner 用文档知识缩小搜索空间。
依据:原文 v2,模型定义见第 3 节,学习和闭环见第 4 节,案例见第 5 节,效果与迁移见第 7–8 节;核对日期:2026-10-24。