Frontier: Towards Comprehensive and Accurate LLM Inference Simulation
核心思路
现代 LLM 服务已经不是“若干个相同副本各跑完整模型”:有 prefill/decode 分离(PDD)、attention/FFN 分离(AFD),有 CUDA Graph、推测解码等改变调度状态的运行时优化,还有推理、agent、RL rollout 这类多轮有状态的请求。Frontier 是面向这种系统的离散事件模拟器,做了两件事。一是结构完整:控制面把部署描述编译成按角色划分的集群 worker,跨集群的 KV 传输、激活传输、EP 同步都是显式事件;运行时优化以 adapter 的形式插进“调度器–batch 引擎”循环,直接改调度器可见的状态。二是决策级精度:算子耗时、通信、KV 预算不再用平均情况的粗略代理,而是按算子类别选特征、用实测校准。作者的核心论点是:在闭环的服务系统里,小误差会被放大,足以改变“选哪个配置”的结论。
1. 背景与问题
设计空间在爆炸:一个 200B 参数的 MoE 模型,可行配置轻松超过 1000 种;在 64 张 H100 上扫 100 个配置要 12,800–25,600 GPU 小时,最多约 18 万美元。多数团队因此放弃系统调优,退回保守默认值。模拟器是自然的替代方案,但现有模拟器(Vidur、APEX、LLMServingSim 2.0、AIConfigurator)在两方面不够。
结构不完整。 它们大多假设一组同构的副本,每个副本拥有完整的模型路径、调度状态和本地 batch 循环。PDD/AFD 不能靠“加一个延迟项”表示:请求要穿过不同角色的集群,KV 或激活的传输是因果边,EP 带来依赖路由的同步。运行时优化也不只是“加速旋钮”,它们改变调度器看到的状态:
- CUDA Graph:vLLM 只在 batch 大小 {1, 2, 4, 8, 16, 32, 64} 处捕获 decode 图,介于两档之间的 batch 按更大的一档重放,33 个请求会执行成 64 个槽位。CUDA Graph 让 TPOT 降低 32%–47%(同址部署)或 37%–60%(PDD),但补齐带来的额外 decode token 多出 23%–46% 或 40%–57%。补齐还改变显存占用和 KV 状态,进而影响准入、分块和抢占。
- 推测解码(MTP):即使给定真实接受率,AIConfigurator 的解析模型仍偏差 27%–67%,并在 5 个低接受率 batch 中的 4 个上预测出相反的趋势(真实加速,它预测减速)。标量期望公式抹平了事件驱动的可变提交带来的非线性。
精度不够做决策。 服务系统是闭环:执行开销决定显存状态,显存限制准入,准入决定排队和后续 batch 的组成。两个层面的误差会沿闭环放大:
- 算子层:batch 组成由调度器在线决定,无法穷举 profile。现有方法用总 token 数这类粗特征,忽略 batch 内各请求长度的差异。Vidur 的 FlashAttention 预测平均误差 32.6%,MoE GroupedGEMM 误差 21.0%。每个算子差 0.1 ms,累积到每个请求就是几十毫秒,足以超过候选配置之间的差距。
- 引擎层:KV 预算是 GPU 显存扣除权重、激活缓冲、CUDA Graph 捕获区和框架内部开销后剩下的部分。多数模拟器近似为“总显存减权重”,对 Llama-3.1-8B 和 Qwen3-30B MoE 分别高估 8.1% 和 27.2%,使模拟出的 decode 吞吐虚高 23.6% 和 32.4%。
两者合起来会导致决策错误:在 16 张 H800 上,APEX 选出的“最佳”配置在模拟中满足 SLA,放到 vLLM 上实测却违反 SLA(TTFT 多 17.5 ms,TPOT 多 8.5 ms)。而这恰好是模拟器本该避免的失败。
2. 方法与创新
Frontier 的出发点是一个观察:vLLM、SGLang 等生产引擎共享同一个控制流骨架,即准入 → 组 batch → 执行 → 完成,区别主要在调度策略和算子后端。因此可以把骨架做成模拟核心,把策略和后端做成可替换的部分。
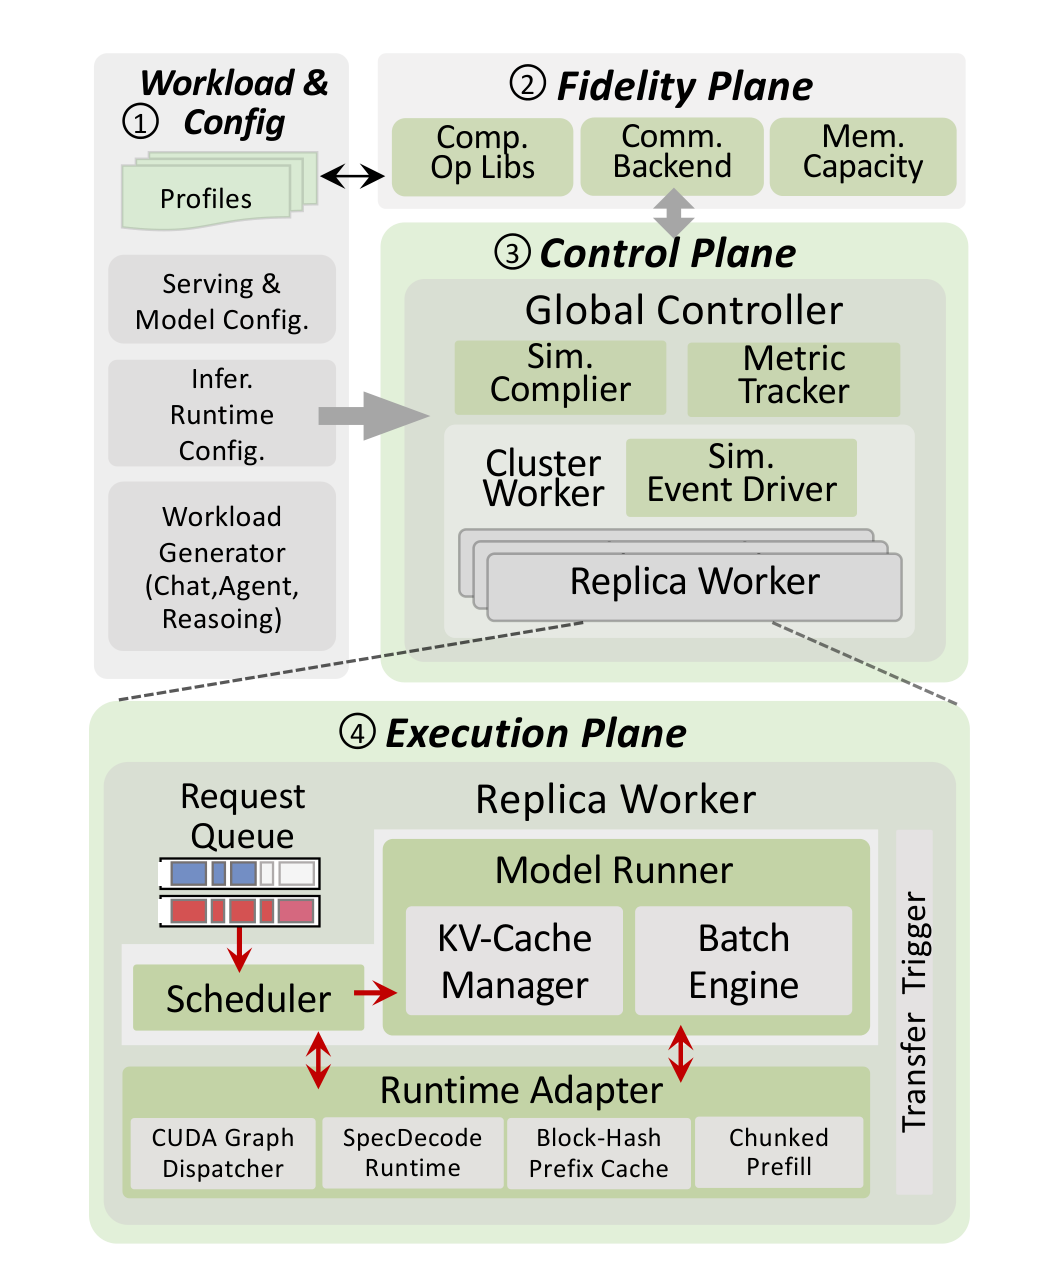
原论文图 6,v2 PDF 第 5 页。① 负载与配置(profile、服务与模型配置、运行时配置、负载生成器);② 保真度平面(计算算子库、通信后端、显存容量);③ 控制面(全局控制器里的模拟编译器、指标追踪器,以及集群 worker 和事件驱动器);④ 执行面(每个副本 worker 内的请求队列、调度器、KV cache 管理器、batch 引擎,以及挂着 CUDA Graph、推测解码、前缀缓存、分块 prefill 的 runtime adapter)。
| 模块 | 负责什么 |
|---|---|
| 负载与配置 | 模型、部署架构、并行方式、运行时选项、请求负载 |
| 控制面 | 把配置编译成可运行的模拟:实例化 worker、绑定通信域、连接跨阶段的事件依赖、设定容量约束 |
| 执行面 | 在每个副本内推进请求生命周期:准入、组 batch、运行时调整、跨集群传输 |
| 保真度平面 | 按需回答“这一步要多久、还剩多少显存”:算子耗时、集合通信开销、KV 预算 |
控制面:把部署编译成角色
两域并行分解。 各引擎描述并行方式的词汇不同,而且常常隐含在运行时里。Frontier 用一个显式的分解统一它们:每个副本由流水线深度 、注意力分片 和 FFN 分片 描述(稠密模型的 退化为 )。同一角色同时承载两个域时,两边必须覆盖同一组卡:
这个分解就是查询保真度平面和通信后端的单位,DP 注意力 + EP 这类布局因此可以直接表达。
三种部署形态映射成不同的角色组合:
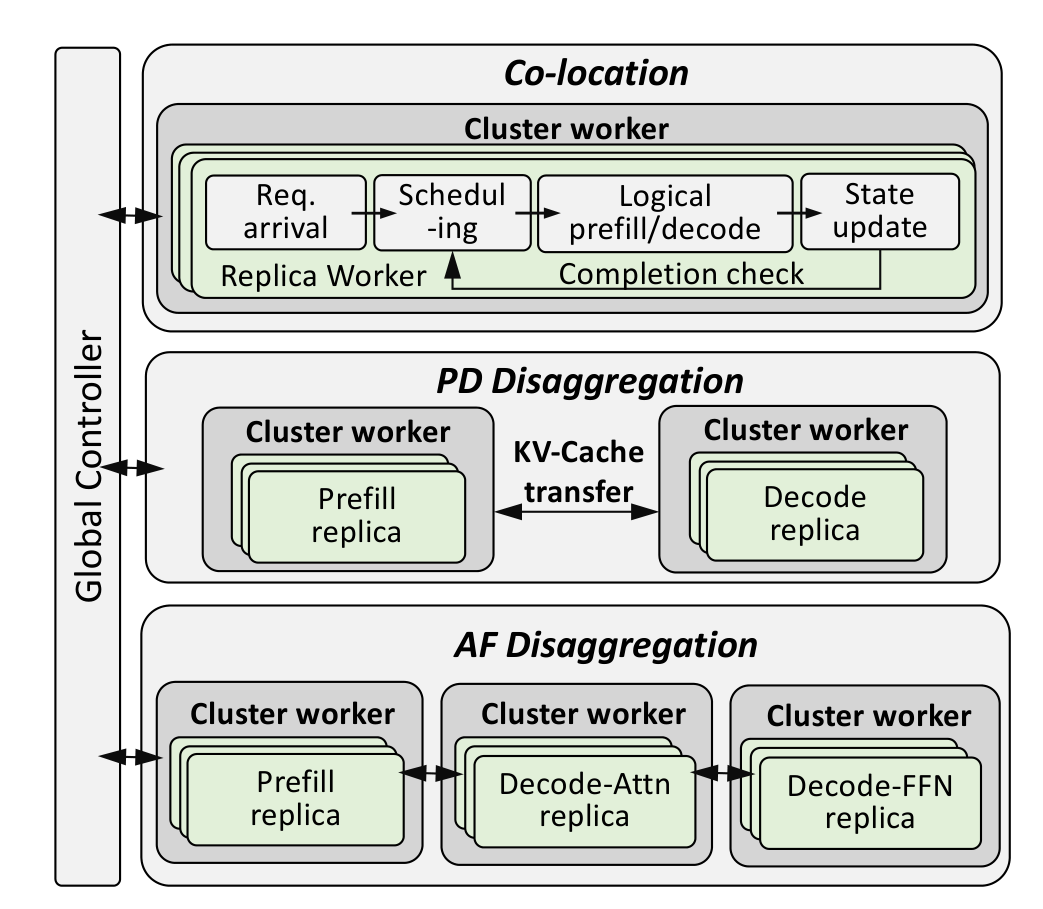
原论文图 19,v2 PDF 第 16 页。同址部署只有一个集群 worker,副本内循环“到达 → 调度 → prefill/decode → 状态更新”;PD 分离有 prefill 与 decode 两个集群,中间是 KV cache 传输;AF 分离再把 decode 拆成 attention 与 FFN 两个集群,中间来回传激活。全局控制器统一协调。
| 部署 | 角色 | 角色之间的依赖 |
|---|---|---|
| 同址 | C:一个集群承载两个域 | 无 |
| PDD | P(prefill)、D(decode),各自承载两个域 | 请求粒度的 KV cache 传输 |
| AFD | P、A(decode 注意力)、F(decode FFN/MoE),A 和 F 各承载一个域 | 每层一次 A→F、F→A 的激活往返 |
依赖都是显式事件。 排队和同步直接从事件图中产生,而不是事后加的修正项:
- 流水线阶段:阶段 结束的事件调度阶段 ,相邻阶段差一个 microbatch。
- PDD 的 KV 传输:prefill 完成后发出
KVCacheTransferStart,对应的End事件到达时,请求才进入 decode 调度。传输耗时由保真度平面按 KV 大小、链路拓扑和当前并发传输数计算。 - AFD 的激活传输:每次 decode 迭代在 A 与 F 之间成对发出传输事件。
- MoE 的 EP 同步:每个 MoE 层,各 rank 分别报告就绪,combine 等到最慢的 rank 就绪才发生。掉队带来的等待因此直接来自逐 rank 的预测,不需要另建一个负载不均模型。
有状态的请求。 推理、agent、RL rollout 的请求携带:要跑几轮推理、每次工具调用的延迟、每轮的 prefill/decode token 数。中间每一轮是普通的 prefill → decode;完成后发出 ThinkingRequeue 事件,等工具延迟过去再重新准入,并粘在同一个副本上,让上一轮填好的 KV 作为前缀缓存命中。最后一轮生成用户可见的回答。
运行时不变量。 组 batch 之前,控制面先固定容量边界,并登记后续准入、分块、抢占要用的约定(CUDA Graph 捕获档位、前缀缓存资格、推测解码的 token 配额)。权重放不下或 KV 块数为 0 时直接拒绝启动;每次准入前按水位线检查块数,不够就抢占,而不是超额分配。
执行面:保留真实调度器,用 adapter 接入优化
调度器原样移植。 Frontier 把 vLLM、SGLang 的调度逻辑原样保留,只重新接线输入输出:请求队列由模拟的到达事件喂入,batch 由事件循环消费,显存压力读的是模拟的 KV 块计数器。保留机制本身,才能复现引擎在压力下的特有行为,例如 vLLM 的水位线抢占和 SGLang 的准入规则。
Runtime adapter。 每个 adapter 声明一种优化改变循环中的哪一小块:
| 改变什么 | 例子 |
|---|---|
| 调度器可见的状态 | 前缀缓存:准入前把命中的 prompt 块标记为“已计算” |
| batch 引擎查询保真度平面时用的 batch 形状 | CUDA Graph:把 decode batch 补齐到下一个捕获档位 |
| 每个请求的进度 | 推测解码:每步提交几个 token |
两个具体例子:
- CUDA Graph:把 batch 补齐到下一个捕获档位,并改用“仅 kernel”的计时;不走图的执行用“含 launch 开销”的计时。这同时刻画了两个相反的效应:补齐增加计算量,图重放去掉 launch 开销。一个标量加速系数无法同时表达这两件事。
- 推测解码(MTP):为每个请求维护计划、验证、接受、提交的 token 数。每个 decode 步变成“起草 → 验证 → 提交”,验证是一次类似 prefill 的前向,可以和普通 decode 拼在同一个 batch 里。同一 batch 里的请求可以有不同的推测深度和接受结果,这正是决定尾延迟的 batch 形状差异。
保真度平面:按“什么决定耗时”选特征
算子分三类:
| 类别 | 例子 | 耗时取决于 | 预测器与特征 |
|---|---|---|---|
| 按 token 数 | GEMM、逐元素、norm | 当前 TP 切片内处理的 token 数 | 线性回归或小随机森林,特征只有 token 数 |
| 依赖序列 | 注意力 | batch 内各请求长度的分布,而非总量 | 随机森林;特征含 batch 大小、总 token 数,以及 prefill/decode 长度的最小、最大值和分位数 |
| 依赖路由 | MoE | token 到专家的分配 | 随机森林;特征含各专家 token 数的方差和最大值、专家选中比例、专家数、模型维度 |
注意力用分布特征,是因为 kernel 的分块和 tile 调度会对长度差异做非线性反应;两个总 token 数相同的 batch,长度组成不同,耗时可以差很多。
profiling 与训练分开。 profiling 在单张 GPU 上以“分片模式”运行:在本地构造每个 rank 的切片,把集合通信打桩替换,因此采集过程与模拟的集群规模无关。每个 kernel 测两种模式:仅 kernel(GPU 端耗时)和含 launch(host 端开销)。
KV 预算。 模仿 vLLM 启动时的空跑:用假权重实例化单个 rank 的分片模型,跑一次定尺寸的前向,从 PyTorch 分配器快照中读出权重显存、torch 峰值增量和非 torch 驻留(如 NCCL 工作区)。KV 预算 = 申请的显存 − 参数显存 − 非 KV 开销。有流水线并行时取各阶段中最差的切片。模拟上千卡的部署也只需要一张 GPU。
通信。 接入 ASTRA-Sim 和 HTSim 作为可插拔后端,按通信域规模选择。
一个 PDD 请求的模拟过程
到达事件 → 进入 P 集群请求队列
   │
P 的调度器(原样移植的 vLLM 逻辑)决定准入、分配 KV 块
   │  runtime adapter:分块 prefill 截断本轮 token;前缀缓存把命中块标为已计算
   ▼
batch 引擎:按 batch 组成查询保真度平面
   (注意力看长度分布,MoE 看路由负载,通信查 ASTRA-Sim/HTSim)→ 本次迭代的完成时间
   │
prefill 完成 → KVCacheTransferStart ──(按 KV 大小、拓扑、并发传输数计时)──▶ End
   │
进入 D 集群调度;每个 decode 迭代:
   adapter 把 batch 补齐到 CUDA Graph 档位,改用仅 kernel 计时
   推测解码时按请求分别记录验证、接受、提交的 token
   每个 MoE 层等最慢的 EP rank 就绪再 combine
   │
完成:提交 token、释放 KV 块;推理请求若还有下一轮 → 工具延迟后 ThinkingRequeue
AFD 的区别在于 decode 被拆成两个集群,每层都在 A 与 F 之间来回传一次激活,F 负责路由、EP dispatch 和同步屏障。作者的总结是:部署形态改变的是事件图,不是模拟核心。
实现
约 7 万行 Python,保留了 Vidur 的基础模块和离散事件工具,把模拟器从单体副本执行路径中重构出来。模型定义直接读 HuggingFace 配置;算子预测器拟合一次、跨部署复用;对外暴露 808 个有类型的命令行选项。
论文没讲清的
- 正文说控制面把“五类”跨阶段依赖做成显式事件,但只列了四类(流水线、PDD 的 KV 传输、AFD 的激活传输、EP 同步),第五类大概是推理请求的重新入队。
- 通信后端“按通信域规模”在 ASTRA-Sim 和 HTSim 之间选择,选择标准没有给出;网络部分的精度也没有单独验证。
- CPU 侧开销沿用 Vidur 的做法(实测 + 预测),作者自己承认可能不够稳健;换引擎版本或换硬件时需要重新 profile 多少,没有量化。
- 随机森林预测器在训练分布之外(新的 batch 组成、更长的上下文、新的 GPU)表现如何,没有分析。
3. 应用与效果
真值为 vLLM v0.10.2(V1 引擎),硬件为 2 台 8×H800;模型为 Llama-3.1-8B(稠密)、Qwen3-30B MoE 和 Step3-316B(用于 AFD);负载为 prefill 重(2048/256)、decode 重(256/2048)、均衡(1024/1024)和 SharedGPT 轨迹。
| 维度 | Frontier | 对照 |
|---|---|---|
| 算子(BF16,p50/p95) | 注意力 3.5%/14.2%,MoE 1.4%/5.3% | Vidur 注意力 55.4%/376.1%,不支持 MoE |
| 初始 KV 预算 | 与 vLLM 相差 ≤ 1.89% | 解析式高估 14.1%–39.7% |
| CUDA Graph 加速比 | 同址差 1.7%,PDD 差 6.1% | AIConfigurator 不建模 |
| 前缀缓存命中率 | 36.98% / 37.11%,与 vLLM 完全一致 | — |
| 推测解码(6 种设置) | 各指标误差 ≤ 11.3% | AIConfigurator 吞吐平均误差 46.9%,低接受率时趋势反转 |
| 端到端,同址(32 项) | 全部 ≤ 9.4% | Vidur 2.9%–45.5%;AIConfigurator 最高 170% |
| 端到端,PDD(32 项) | 全部 ≤ 11.0% | AIConfigurator 最高 200%;Vidur、APEX 不支持 |
| 端到端,AFD | TPOT ≤ 6.4%,吞吐 ≤ 7.0% | 无模拟器支持 |
附录在 H20 上做了同样的检验,端到端平均误差都在 10% 以内。
四个用例都只在模拟中完成:
- SLA 约束下的 Pareto 前沿(256 张 H800,Llama-3.3-70B,48 万多个候选配置):要求每用户 50 tok/s 时,TTFT ≤ 3 s 下 PDD 最好(13.7 万 tok/s),TTFT ≤ 500 ms 下 AFD 最好(11.6 万 tok/s,PDD 降到 10.1 万)。只看宽松 SLA 会误以为 PDD 总是更好。
- 异构 GPU 分配(1024 卡,Qwen3-235B):PDD 把 decode 全换成便宜的 H20、P:D=1:1 时,每美元吞吐提高 33%;继续把比例推向 decode(2:6),账面上更省,但 prefill 容量不足、排队让 P95 TTFT 违反 SLA。AFD 把注意力换成 H20 可行,把 FFN 换成 H20 则不行,因为 FFN 是计算受限的。
- 多轮推理的调度:现成的 skip-join MLFQ 只改善 1.45%,因为它只看当前这一轮的大小,而重尾会话的最后一轮可能很小。作者据此设计了带会话历史的双队列调度器 H2Q-BR,P95 回答可见 TTFT 降低 30.4%,隐藏规划吞吐提高 23.2%。
- RL rollout 中途切换并行布局:活跃轨迹降到 10% 以下时,从高 DP 布局切到宽 TP 布局(切换开销 4.52 s),rollout 总时长从 528.8 s 降到 259.1 s。
证据边界
- 精度验证只覆盖 16 卡、vLLM 一个引擎(附录加了 H20);上千卡规模和全部四个用例都没有实机对照,H2Q-BR 等结论只是模拟结果。
- 没有公开的 AFD 实现,AFD 的真值来自作者的内部实现,并且是离线校准的,因此只比较了吞吐类指标。两位作者来自 StepFun / Anuttacon,也是 Step-3 论文的作者,而 Step-3 的部署正采用 AFD。
- 与基线的比较对它们不完全公平:AIConfigurator 本是为 TensorRT-LLM 和 H200 设计的,放到 vLLM 与 H800 上表现变差;它对 Qwen 的 MTP 支持是作者自己改的;与 APEX 比较时关掉了 APEX 不支持的 vLLM 优化。表 1 的能力对比依据的是 2026 年 4 月的开源代码,并且是作者自己的评估。
- 推测解码的验证使用强制设定的接受率,不是真实分布。摘要中“44.9% → 6.4%”只是 SharedGPT 轨迹上的平均值。
- 异构分配用例的价格取自公开云价,“每美元吞吐至少提高 8%”的门槛由作者设定。
对 CKG 的启发(阅读判断)
两点值得记下。其一,结构与开销分开建模:哪些事件、哪些依赖(KV 传输、EP 同步、多轮重新入队)属于结构,用事件图表示;每一步要多久属于开销,交给可替换的预测器。新部署形态只改结构,新硬件只重新校准开销。其二,特征要按“什么决定了这个量”来选:注意力看长度分布,MoE 看路由负载,KV 预算要实测非权重开销。在闭环系统里,平均情况的代理会把小误差放大成决策错误,因此知识条目除了记录数值,还应记录它在什么条件下会改变决策。
相关:Simthesizer 同样针对新服务机制打破固定流水线的问题,用可增长的 DAG 和编码 agent 扩展模拟器;MLSYSIM 用第一性原理公式而非事件模拟分析瓶颈;Glia 在 Vidur 上让 agent 设计服务策略;RoofLang 走相反方向,不按具体服务栈校准,而用 roofline 评估与实现无关的架构上限。
依据:原文 v2,动机与两类不足见第 2.2 节,总体架构见第 3.1 节,控制面(并行分解、依赖事件、有状态请求)见第 3.2 节,执行面与 runtime adapter 见第 3.3 节,保真度平面见第 3.4 节,精度评测见第 5 节,四个用例见第 6 节,局限见第 7 节,H20 结果、PDD/AFD 工作流与 H2Q-BR 见附录 A–B;核对日期:2026-11-03。