Glia: A Human-Inspired AI for Automated Systems Design and Optimization
核心思路
让 AI 像系统研究者一样提出机制假设、增加观测、执行实验、解释结果并组合方案。它不只根据单个性能分数改代码,还能深入模拟器查看中间指标,找到为什么慢以及应该修改哪个机制。
1. 背景与问题
LLM 集群的路由策略受请求长度、到达模式、prefill/decode 比例、KV cache 和调度器共同影响。直接让 LLM 写一个策略,往往缺少验证;只在“生成代码 → 返回分数”的循环中搜索,又可能得到许多难以解释的权重与阈值。
Glia 希望把探索提升到假设与机制层面:观察什么,排除什么解释,下一次实验如何区分它们。研究对象包括请求路由、batch scheduling 和 autoscaling。
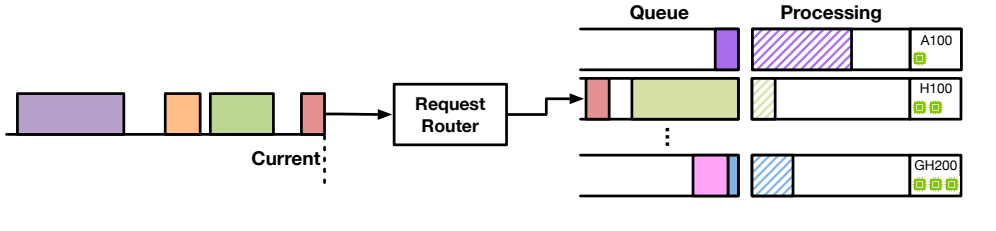
原论文图 1,v5 PDF 第 3 页。它展示优化对象,而不是 Glia 的 agent 架构;路由决策必须考虑副本内部状态,单看请求数量可能不够。图中的硬件是概念示意,主要实验另有具体配置。
2. 方法与创新
Researcher 与 Supervisor 的分工
| 角色 | 职责与可见信息 |
|---|---|
| Researcher | 阅读代码、提出与实现方案、运行模拟、编写分析脚本、检查指标和修订假设 |
| Supervisor | 观察任务与研究输出,通过提问、提醒和反馈推动探索;没有直接代码库访问,不负责提供新设计 |
单上下文版本 SCG 共享一段连续研究历史。上下文变长或用尽后难以继续,MCG 则运行多条独立 SCG 轨迹,最后按性能选优;包括顺序与并行两种形式。这是运行中保留历史与跨轨迹选优,不是已经构建了长期、跨任务、可审计的领域知识库。
一个有代表性的发现过程
论文第 3.3 节追踪了一次路由设计:
- 比较简单路由策略后改善有限,转向增加指标,拆解排队、执行、重启和显存压力。
- 观察到约 26% 的请求发生重启,提出“显存不平衡 → 重启 → 浪费计算”的候选解释。
- 多个负载均衡变体仍不能解决问题,Supervisor 追问其共同的结构性原因。
- Researcher 进一步认识到,decode 会继续增长 KV cache,入队时平衡并不保证以后不溢出;需要准入控制,给未来增长留出 headroom。
- 实现并调节 Head-Room Allocator,再与 shortest-prefill-first 组合,改善平均完成时间。
特别有用的反例是:初版 headroom 策略几乎消除了重启,端到端时延却从约 40 s 恶化到超过 50 s。避免重启并非唯一目标,过度排队也会拖慢请求;之后仍需调参和机制组合。
这表明“重启少了”是中间证据,不能代替最终目标。解释必须同时容纳显存风险、准入等待和执行效率。
3. 应用与效果
主要模拟实验使用 Vidur、4 张 A10、Llama-3-8B-Instruct,基于 ShareGPT 调整长尾输入/输出长度,7.5 QPS、突发到达。底座主要是 o3,每项优化设定约 30 美元预算,实验使用 10 个随机种子。
| 结果 | 具体条件与解释 |
|---|---|
| 相对 OpenEvolve 约 1.6× | 100 次模拟预算下,MCG 所发现策略的平均响应时间比值;不是吞吐提高 1.6× |
| 小预算下仍有收益 | 15 次模拟预算时,SCG 相对几种算法发现基线的平均响应时间改善约 1.3–1.4× |
| 真实部署检验 | 在 Production Stack / vLLM、4 张 A10 上实现路由,7.5 QPS 时相对 LLQ 的 slowdown 降低超过 4.5× |
| 跨层优化 | 变化负载下联合优化路由、batch scheduler 与 autoscaler,GPU×hours 比论文标准栈减少约 40% |
slowdown 定义为 。真实系统的 4.5× 与模拟对 OpenEvolve 的 1.6× 使用不同指标和对照,不能混用。
新版还在另一种 prefill-heavy 负载、8 张 H100、70B 模型下重新优化,目标改成满足 P90 TTFT 的约束并最大化 QPS。它支持自动适应新目标的可能性,但不是证明旧策略或旧解释无须重验即可迁移。
证据边界与记忆问题
不能笼统说 Glia“每一步都从零理解系统”:SCG 会利用已有历史,Supervisor 会提醒旧发现,MCG 则通过独立轨迹扩大探索。更准确的缺口是,本文未展示一个可持续维护、跨独立任务复用且带证据状态的领域知识库。效果也受模拟器、负载、观测指标、底座模型和预算影响,尚未证明通用系统设计能力。
对 CKG 的启发(阅读判断)
可把 CKG 作为实验前的假设来源和实验后的归纳位置,保存“条件 → 机制假设 → 区分性实验 → 观测 → 修订”。除了成功策略,还应保存失败原因,例如“降低重启却增加排队”。然后比较有无持久知识时的实验次数、耗时、最终性能及迁移失败,才能检验记忆是否真有价值。
相关:Unicorn 提供可学习的机制图,QMatSuite 讨论实验知识的复审与固化。
依据:原文 v5,发现过程见第 3.3 节,agent 和上下文机制见第 4 节,模拟、实机与跨层结果见第 5 节;按首次预印本年份 2025 归档,内容以 2026-04-03 更新版为准。核对日期:2026-10-24。