Koi: Evidence-Guided, Self-Calibrating Planning for Multi-Cloud, Heterogeneous LLM Inference Fleets
核心思路
在跨云、异构 GPU 集群上部署一批 LLM 推理任务,要为每个任务选择硬件、并行方式、引擎配置和副本数,而且各任务争抢同一批卡。Koi 用一张固定的因果图“决策 → 运行时中介量 → 服务结果”把 LLM 的定性知识和遥测数据接起来:LLM 提出带适用范围的机制假设和候选部署,确定性代码负责预测、打分、校验和整集群联合选择;每次真实部署都在检验它所触及的机制,置信度随证据更新,再反过来指导下一轮规划。
1. 背景与问题
推理服务商面对的是不断变化的任务组合:在线任务有延迟目标(TTFT、TPOT),批处理任务有截止时间。每个任务要定下运行环境、加速器、并行与引擎配置、副本数,并随着任务到达、结束和容量变化不断修订。
即使只看一个任务,选择也影响很大。Llama 3 70B 在 AWS A10G 上,五种可行的 TP/PP 组合吞吐相差 4.4×,每 token 成本相差 7.5×:跨两台 4 卡机的 TP4/PP2 跑出 180 tok/s、花费 0.97 美元,单台 8 卡机的 TP8/PP1 只有 162 tok/s、却花费 2.16 美元。难点有三层:
| 难点 | 表现 |
|---|---|
| 空间巨大 | 每个部署约 140 个配置旋钮(环境、并行、引擎、batch、KV cache、量化、推测解码、P/D 分离等),单任务至少 种配置;整集群计划随任务数指数增长 |
| 预测不准 | 用实测峰值校准的 roofline 模型误差可达 4.7×;直接问 Claude Opus 4.8、GPT-5.6 Sol,吞吐分别高估约 4× 和 9× |
| 任务之间耦合 | 逐个任务贪心分配时,先到的任务拿走唯一的 H100,即使它在 A100 上也能达标,后到的在线任务却只能违约或等待 |
已有方法各管一段:服务引擎和路由器只在给定部署内调度请求;SkyPilot 等多云编排把加速器和配置留给用户;AIConfigurator、Mélange、Helix 等只为单个或固定一组模型选配置。基于搜索的方法也有两点不足:
- 贝叶斯优化和 LLM 引导的进化搜索只从端到端分数学习,说不清低吞吐来自流水线气泡还是 KV cache 压力,因而不知道该怎么修,也不知道这条证据还适用于哪些任务;
- 每次试验都是一次真实部署,会占用别人需要的容量,还可能让正在运行的任务违约。
2. 方法与创新
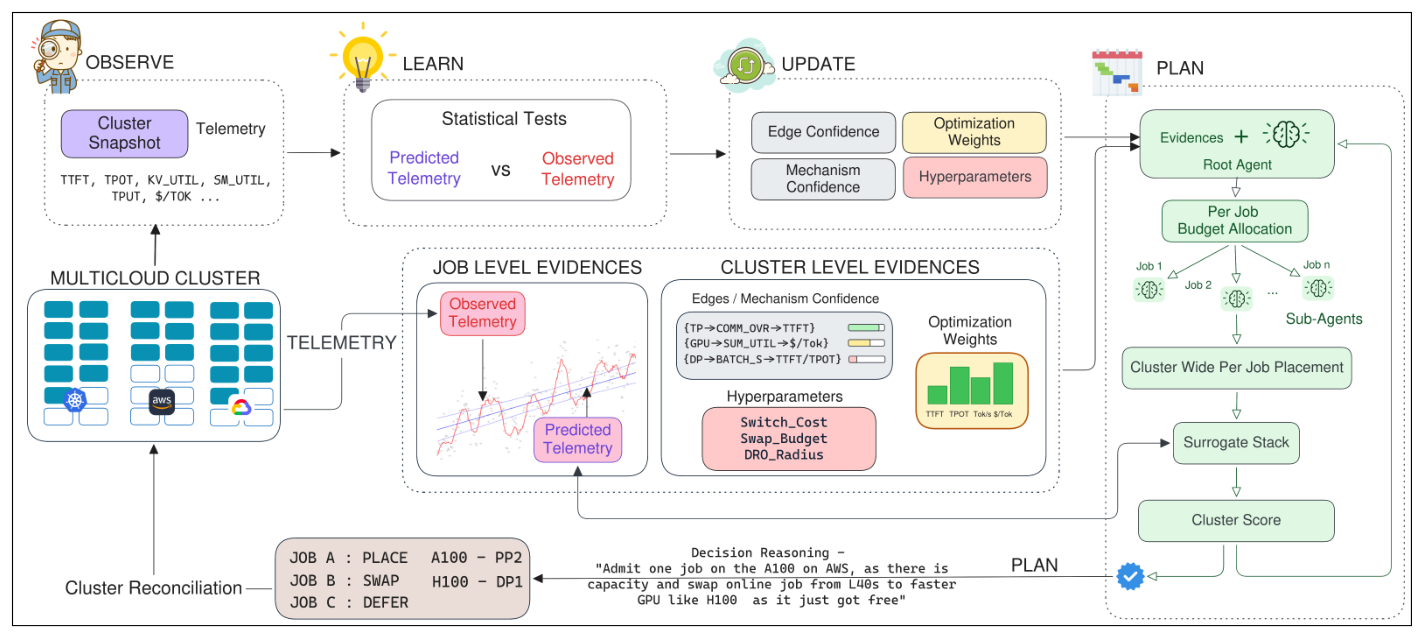
原论文图 3,v1 PDF 第 6 页。左侧采集集群快照和遥测,中间把预测与观测对比、更新边与机制的置信度及超参数,右侧由 root agent 与各任务子 agent 提出候选,经代理模型和集群打分后提交计划。
问题形式化
部署按层级组织:chain 是某环境、某配置下的一份模型副本;rank 是 个相同 chain(数据并行度为 );ladder 是分给某任务的若干 rank;plan 为每个活跃或排队任务各指定一个 ladder(排队任务可以是空集,即暂缓接纳)。
每个 ladder 产生五项结果:J_i \le 0$,其中的 max 项保证没有哪个目标被忽视。整集群目标是
约束 C1–C5 依次为:资源可用、物理可行(显存够、TP 整除注意力头数等)、考虑预测误差后违约概率不超过 、每个 tick 最多改动 个活跃任务、配额与优先级。真实的“配置 → 结果”映射未知且会漂移,所以 Koi 只能“估计 → 部署 → 观察 → 修正”。
因果图怎么建
图分三层,只有最底层是事先固定的:
| 层 | 内容 | 来源 | 是否变化 |
|---|---|---|---|
| 骨架 | 节点:决策 (硬件、引擎、并行、量化、batch、路由)、中介量 (KV cache 利用率、流水线气泡、通信延迟、显存压力、SM 利用率,都能从遥测读到)、结果 (上面五项指标)。边只允许 与 | 初始化时注册(论文没说由谁写、有多少条,看起来是人工预设) | 不变 |
| 边的置信度 | 每条边一个 , 累计支持、 累计反对;置信度 ,另记后验不确定度 | 只由部署证据更新 | 每个 tick |
| 机制 | 一条 路径 + 适用范围(模型、硬件、负载、条件)+ 一句话陈述 + 自己的 Beta 状态 | LLM 提出;必须是注册边上合法、不重复的路径才收录 | 越积越多(真实集群 3 小时累计 64 条) |
“所有效应都必须经过可观测的中介量”是关键约束:这样每条机制都能被遥测证实或证伪。没有可测中介量的决策“能打分但不能检验”。
以一条机制为例,它的生命周期是:
① 收录  LLM 提出“70B 稠密模型、A100 上,PP↑ → 流水线气泡↑ → 吞吐↓”
        路径合法 → Beta(1,1),置信度 0.5,不确定度最大
② 部署  某任务用了 TP4/PP2 的 A100 部署,落在该机制范围内
        代理模型事先给出预测:气泡比例 V̂、吞吐 Ŷ
③ 观测  遥测给出 V_obs、Y_obs;双侧 CUSUM 累积“观测 − 预测”残差,
        只有持续偏差才算“偏离”,孤立波动不算
④ 归类  按 V、Y 是否偏离分到四个象限(下表)
⑤ 更新 支持则 α 增加,反对则 β 增加;证据越多,U 越小| 象限 | 中介量 | 结果 | 含义与更新 |
|---|---|---|---|
| Q1 | 符合 | 符合 | 整条路径成立 → 支持 |
| Q2 | 符合 | 偏离 | 没问题, 或其他中介量有问题 → 用不变因果预测(ICP)判断更新哪些边 |
| Q3 | 偏离 | 符合 | 同上,方向相反 |
| Q4 | 偏离 | 偏离 | 反对 |
Q2/Q3 正是保留中介量的价值:只看端到端分数的方法分不清是哪一段推理错了。另外,没有单独的建图实验:每次部署首先服务真实任务,顺带检验它所触及的机制。
预测数字本身来自确定性代理模型(基于 AIConfigurator 的算子级 profile 加回放模拟;没有 profile 的模型借用同硬件上最接近的架构并按实测速度比缩放),不是由图算出来的。图决定的是往哪看、试什么、相信什么。
因果图怎么用
每 5 分钟一个 tick,图在四处起作用:
1. 缩小搜索范围。 root planner(递归语言模型 RLM)读取集群快照,给每个任务分一本“预算簿”(可考虑的 GPU 类型和实例池)。每个任务一个子 agent,拿到所有范围匹配的机制,并能反向查询图:例如 TTFT 超标 ← 经过哪些中介量(KV cache 压力、通信延迟) ← 受哪些决策影响(TP、batch 上限、GPU 类型)。它只在这些旋钮上提出少量候选,而不是遍历约 140 个旋钮。
2. 决定做什么实验。 候选经物理可行性校验后,由代理模型预测,再用计划分数挑选:
是利用项; 是风险项(用历史残差分位数加宽 得到预测区间,估计 SLO 违约概率);Switch 是冷启动、并行运行、排空、过渡损失四项切换成本。探索项 直接来自图:一份计划若会检验还不确定的边或机制,就额外加分。高置信度的关系引导利用,不确定的关系引导探索。
3. 跨任务迁移。 证据挂在机制和适用范围上,而不是挂在“某个任务的某个配置”上,所以任务 A 积累的证据,任何落在同一范围的任务 B 都能用。贝叶斯优化学的是单个负载的“配置 → 结果”,换负载就得重来。
4. 调节规划的激进程度。 滑动窗口内落在 Q1 的比例越低,说明预测越不可靠,“遗憾”信号 越大:探索权重 和每 tick 允许改动的任务数 随之上调。此外,切换惩罚 随实际重配置频率上调以防抖动,风险半径 按预测区间的实际覆盖率放宽或收紧。
最后由联合选择器在有限容量下为每个任务至多选一个 ladder。因为所有任务的候选在同一份计划里竞争,“把稀缺的卡给谁”的机会成本才能体现出来。root 可以追加候选,但不能推翻确定性分数、容量检查和约束;LLM 也改不了置信度,只有部署证据能改。
论文没讲清的
初始边集由谁定、有多少条;Beta 每次增加多少(固定计数还是按残差加权);ICP 在 Q2/Q3 中的具体判定规则;机制置信度除了作为子 agent 的上下文外,是否还以其他方式影响候选生成。这些需要看开源代码(tandemn-koi)。
实现上,批任务把提示文件分片,由自研分片管理器协调;在线任务通过 NVIDIA Dynamo 部署,Koi 决定 chain 配置和副本上限,Dynamo 在上限内自动扩缩容。
3. 应用与效果
评测包括一个真实集群(104 张异构 GPU,跨 3 个 GCP 区域,3 小时)和三个模拟设置(用 LLMServingSim 2.0 执行,与 Koi 内部的代理模型分开)。每个设置混合 25 个在线和批处理负载,覆盖 10 种模型。所有用 LLM 的方法都用 GPT-5.6-Luna。总分是达标质量、接纳覆盖、效率三项的几何平均。
| 设置 | 对比最强基线 |
|---|---|
| 真实集群 3 小时 | 总分 94.5 vs 84.4(OpenEvolve);goodput +17.8%,$/token 低 20% |
| 异构模拟 400 GPU / 3 小时 | 总分 70.8 vs 54.3(EvoX);goodput +45%,$/token 低 31% |
| 异构模拟 800 GPU / 12 小时 | 总分 63.1 vs 50.0;goodput 只高 5.7%,成本略高 |
| 同构模拟 12 小时 | 总分 56.7 vs 50.7;goodput 只高 1.3% |
消融(3 小时模拟)的总分为:纯 LLM 35.3 → 加确定性工具 51.6 → 完整 Koi 70.8;去掉因果图降到 58.3,关闭在线学习降到 54.8。可见大部分收益来自 LLM 周围的结构,而不是 LLM 本身。随着部署增多,因果不确定度的中位数下降约 41×,支持预测路径的机制检验比例从 1.9% 升到 19.1%。
证据边界
- 真实集群只比较了 3 个基线(因成本省略非进化类方法),时长 3 小时;表中没有给出“至少三次运行”的方差或区间。
- 模拟中各方法的绝对 SLO 达标率都很低(Koi 的 TTFT 达标率 28.79%),优势主要是相对的;12 小时和同构设置下领先幅度明显缩小。
- 总分是作者设计的三支柱几何平均,批任务 goodput“未按时完成即为零”,单个决策就能左右结果:换底座模型时,两者 99.3% 的 goodput 差距来自同一个批任务的配置选择。
- 计划质量依赖两条假设:候选覆盖到近优解(Assumption 1)和平稳条件下收敛(Assumption 2),文中未证明;作者也承认 12 小时运行不足以达到收敛条件。
- 基线多为作者移植或改写:Prism 是启发式移植,EvoX 的适应度用静态放置信息而非模拟结果;附录称部分基线驱动尚未注册到 CLI。文中基线数量有“九个”“十个”两种说法,附录表 7 的各类旋钮数显示为未解析的引用。第一作者单位 Tandemn 即该系统的开源方。
对 CKG 的启发(阅读判断)
Koi 的“机制”几乎就是一种可证伪的知识条目:因果路径(决策 → 可观测中介量 → 结果)+ 适用范围 + 自然语言陈述 + 支持/反对计数。LLM 只能提议,置信度只由实测证据改变;不确定度高的条目反过来决定下一次值得做什么实验。还有一条很实用的约束:没有可测中介量的决策“能打分但不能检验”,知识库里的因果断言也应绑定至少一个可观测量,否则无法被证伪。Q2/Q3 象限(中介量对、结果错,或相反)则提示:记录中间观测,才能判断是哪一段推理出了错。
相关:Unicorn 同样在配置与性能之间保留中介量来学习因果性能模型;GPTuner 用 LLM 读文档、再用贝叶斯优化调配置;RWM 强调实验经验必须带上环境前提才能迁移;Simthesizer 与本文评测用的 LLMServingSim 同属一个模拟器谱系。
依据:原文 v1,动机与难点见第 1–2 节,形式化见第 4 节,因果图与机制见第 5.2 节,计划打分见第 5.3 节,自校准见第 5.4 节,规划器与实现见第 5.5–5.6 节,实验见第 6 节及表 1–5,基线实现见附录 B;核对日期:2026-11-01。