MLSYSIM: First-Principles Infrastructure Modeling for Machine Learning Systems
核心思路
把 ML 系统设计变成可执行的约束分析:工作负载提出需求,硬件和环境提供资源,带单位的公式计算瓶颈、成本及约束。事实只登记一次,具体问题通过 scenario 选择事实并组合求解器,每个输入都能追查来源或估计依据。
1. 背景与问题
选 GPU、并行策略或部署地点时,计算、显存、通信、排队、价格、能耗会同时影响结果。实测需要目标硬件,细粒度模拟又很慢;手算虽然快,却容易混淆 bit/byte、峰值/有效吞吐及未经说明的常数。
MLSYSIM 的定位是架构分析、容量规划、教学和设计空间预筛选。它把常用系统公式变成可组合的分析引擎,并不等同于学习得到的因果图,也不替代 profile 或精细仿真。
2. 方法与创新
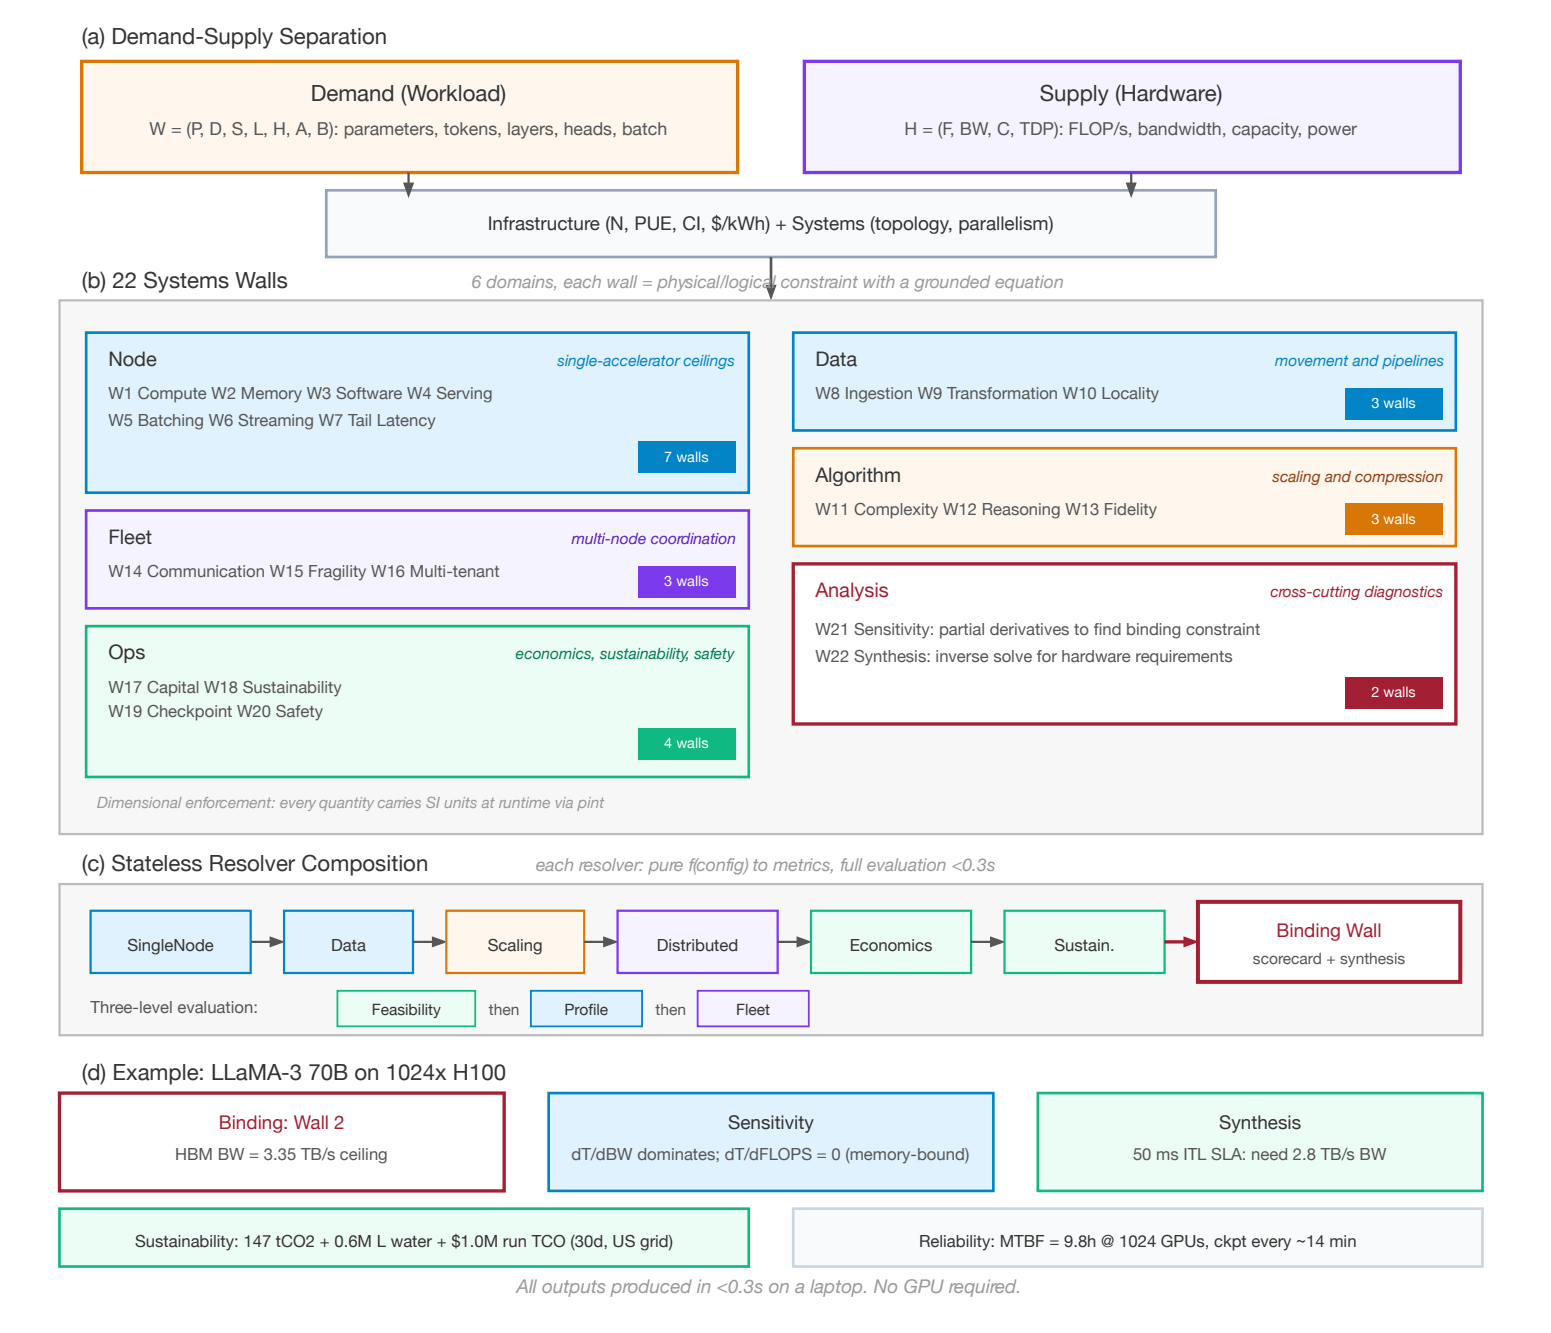
原论文图 1,v1 PDF 第 7 页。先看顶部需求与供给,再看中部的约束类别;底部展示如何输出 binding wall、敏感性和硬件需求。图中数值依赖其示例假设。
把事实、公式和问题实例分开
| 层次 | 保存什么 | 为什么要分开 |
|---|---|---|
| Workload | 参数量、层数、序列长度等,降低为硬件无关的计算图 | 同一模型可比较不同硬件 |
| Hardware | 算力、带宽、容量、功耗等规格 | 同一硬件可评估不同负载 |
| Infrastructure / Systems | 电网、价格、PUE、互连拓扑、并行方式 | 环境和部署结构不能藏入常数 |
| Registries | 带类型、单位与来源的可复用事实 | 避免在每次分析中复制数字 |
| Scenario | 当前要回答的问题、目标和选用条目 | 按问题绑定具体条件 |
| Resolvers | 输入到指标的确定性映射、反求或优化 | 组合分析过程,而非散落的手算 |
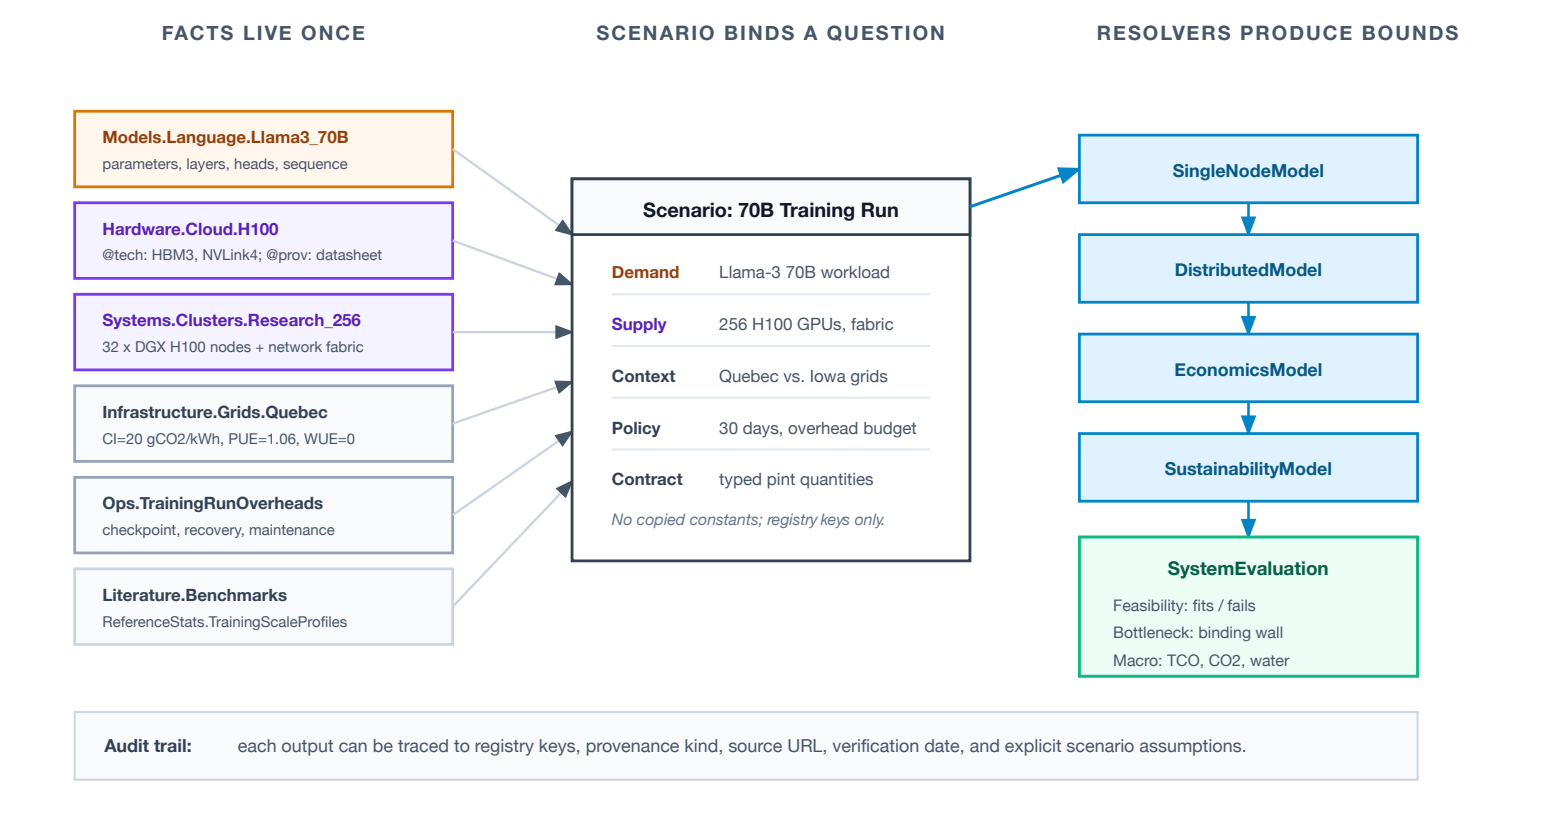
原论文图 3,v1 PDF 第 10 页。这张图对知识库设计尤其有用:左侧是长期维护的条目,中间是问题实例,右侧是可执行的推导链与审计记录。
注册表使用 YAML,Pydantic 校验结构;@tech: 复用技术类别事实,@prov: 引用来源目录。来源类型包括 datasheet、literature、industry report,也包括 estimate、derived、illustrative、heuristic。因此“有来源记录”不等于“全部来自测量”,必须把证据类型一起暴露。
单位是运行时约束
物理量通过 Pint 携带单位;FLOP 还有独立的量纲。带宽与算力直接相加会报错,GB/s 与 Gb/s 的转换必须正确。类型与量纲检查能阻止一类实现错误,但不能检查公式是否适用于当前情境。
用 binding wall 表达当前瓶颈
以论文的简化 Roofline 为例:
表示有效效率; 是该抽象下的估计,尚不能直接当作含通信、排队与框架开销的完整请求时延。显存容量不足还应先判不可行。
当访存项主导时,只提高峰值算力通常不会改善这个模型中的时间;提高带宽才会降低它。模型也可反求目标时间所需的带宽,或计算敏感性来决定优先测什么。
论文将 22 类 Systems Walls 分为 Node、Data、Algorithm、Fleet、Operations、Analysis 六组,由 28 个 resolvers 支持:23 个前向模型、2 个分析 solver、3 个 optimizer。统一接口返回有单位的结果,依次检查可行性、性能、经济与环境指标。
3. 应用与效果
论文报告在普通笔记本上以亚秒级速度探索配置,并用七个已发表基准锚点核对实现。选取三例:
| 锚点 | 预测与对照 | 能支持什么 |
|---|---|---|
| Llama-2 70B,双 H100,FP16、batch 1 | ITL 约 43 ms,对照 40–50 ms | 特定配置上的一阶时延估计 |
| Llama 3 大规模训练 | MFU 约 39.1%,对照 38–43% | 在给定效率因子等条件下接近报告范围 |
| GPT-3 碳排放 | 由已知能耗算出约 552 t CO₂,与报告一致 | 核对碳排放换算,不是独立预测训练能耗 |
这些证据混合了范围对照、校准、原公式重现与实现校验,不能合并成统一的“预测误差很低”。例如分布式训练的 本身参考了系统级经验;七个锚点也没有逐一覆盖全部 22 类约束。
适用边界
主要模型省略或粗化了微架构效应、真实网络拥塞、部分运行时开销、异构节点和长时间动态行为。部分压缩精度模型还是启发式曲线。适合先判断瓶颈、筛选方案,再决定测量预算;不能仅凭单位正确和带出处就把结果当作真实系统的精确预测。
对 CKG 的启发(阅读判断)
可将“规格事实、机理公式、适用条件、校准参数、实验锚点、scenario”分别保存,分析时组合,输出时保留引用链。特别值得借鉴的是类型与单位约束、来源类型和 binding wall。进一步加入模型误差、未建模开销和证据更新机制,才能服务持续演进的系统知识库。
相关:MSA 讨论按题建模,Unicorn 通过测量学习性能机制。
依据:原文 v1,架构与来源见第 3 节,公式和约束见第 4–5 节,验证见第 6 节,限制见第 9 节;核对日期:2026-10-24。