RoofLang: Enabling AI-Driven Architecting of LLM Inference Systems
核心思路
现有让 AI 优化推理系统的做法(kernel agent、调框架参数)都以 profiling 为反馈,搜索范围被现有软件栈锁住:某种架构即便本质上更好,只要现有栈缺功能或实现得不够快,就测不出来。RoofLang 想让 AI 直接“设计推理系统的架构”,为此提供三样东西:用计算图 + 硬件图描述工作负载和平台;用一组保持语义的图变换和放置原语作为 AI 的动作空间,保证 AI 改出来的架构算的还是同一个东西;用基于 roofline 的离散事件模拟器给出与具体实现无关的评估。AI 在“提出变换 → 模拟 → 看 trace → 再提”的循环里改进架构。作者用它比较了四个前沿 MoE 模型的解码上限,并让 Claude Code(底层换成 DeepSeek V4 Pro)自主为 DeepSeek V4 Pro 找到三种新架构,在模拟中提升 6.23%–50.1%。
1. 背景与问题
AI 已经开始承担 LLM 推理优化的实质工作:写 kernel、调编译器生成的代码、调框架配置、优化服务路径。这些方法几乎都围绕 profiling 组织:找出当前实现的热点,改一处,再测是否变快。反馈清楚,但上限是被测的那套软件栈:
- 一个更好的架构可能需要现有栈没有的功能,比如某种切分方式或通信模式;
- 也可能现有栈有这个功能但实现很差,测出来反而更慢。
两种情况下,profiling 都会把好架构判成坏架构,搜索永远到不了那里。
作者认为,要让 AI 从零设计并持续改进推理系统架构,需要三样东西:
| 要素 | 为什么需要 | RoofLang 的做法 |
|---|---|---|
| 通用的工作负载表示 | 不能绑定某个框架 | 计算图 + 硬件图,均由外部提供并保证正确 |
| 可验证的架构动作 | AI 自主改动时,必须保证改出来的东西仍然正确 | 预定义、带前提条件的放置与图变换原语 |
| 与实现无关的评估器 | 评估架构好坏时,要排除软件栈实现质量的干扰 | 只用算子的解析属性(FLOPs、字节数)和硬件规格做 roofline 离散事件模拟 |
2. 方法与创新
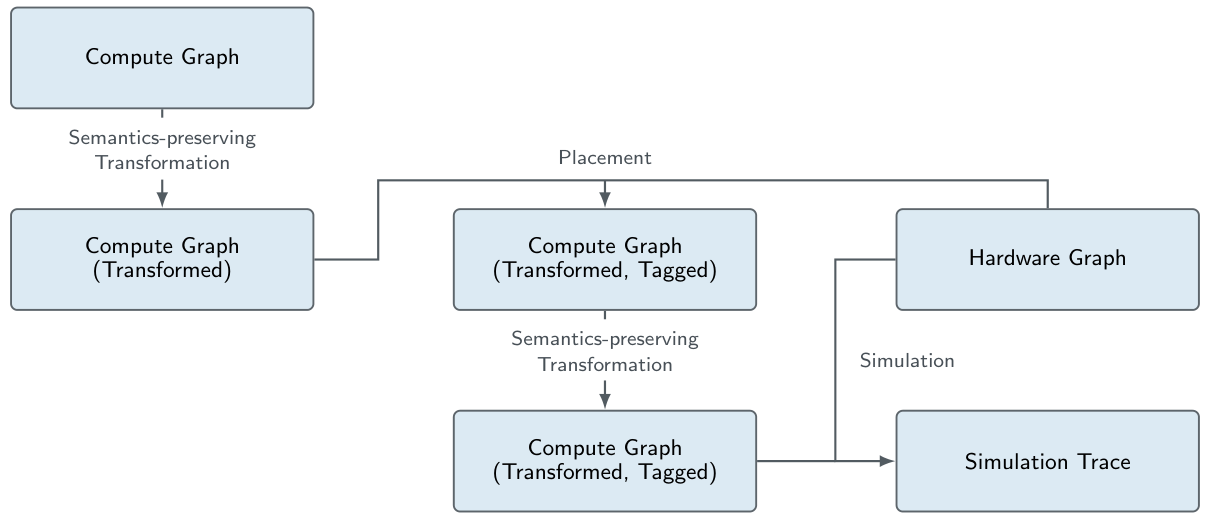
原论文图 2,v2 PDF 第 3 页。外部提供的计算图先经过保持语义的变换;放置把变换后的计算图和硬件图结合,给算子和张量打上设备标签;之后还可以继续做保持语义的变换(例如改变通信的实现方式);最后由模拟器执行打好标签的计算图,输出 trace 作为下一轮的反馈。
两张输入图
计算图。 节点是算子(attention、GEMM 等),记录输入输出张量的形状、dtype、FLOPs 和数据搬运量;边是张量的数据依赖。算子分为无副作用的(只能通过输出张量观察到)和有副作用的(还会改外部状态)。这个区分决定了后面哪些算子可以被复制或合并。
硬件图。 节点是计算设备(CPU、加速器、网卡、交换机,带各精度的峰值 FLOP/s)或存储设备(DRAM、HBM、SSD,带容量);边是互连(PCIe、NVLink、InfiniBand 等,带带宽和延迟)。
两张图都必须由人提供并保证正确,RoofLang 不负责验证。
动作空间:放置 + 保持语义的变换
放置原语只有两个:operator.set_compute 把算子指派给某个计算设备(可选指定 stream/队列),tensor.set_memory 把张量指派给某个存储设备。
图变换原语每个都是预定义、带前提条件的结构化改写:
| 原语 | 作用 |
|---|---|
add/remove_control_edge | 增删两个 kernel 之间的先后顺序约束 |
insert/remove_identity | 插入或删除恒等算子,用来表达 ToHbm、ToDram、ToNvme 这类数据搬运 |
fuse_kernels | 按预定义规则把子图融合成一个外部边界等价的算子,例如 qk-norm-rope 融合 |
split_kernel | 把一个算子拆成等价的分片子图并补上通信算子 |
dup_kernel / dedup_kernel | 复制或合并无副作用的算子:“算一次再广播” ⇔ “广播输入再各算一次” |
merge_gather_scatter | gather 后紧跟 scatter:切分维度相同则换成逐对的直连边,不同则换成 all-to-all |
merge_gather_broadcast | gather + broadcast → all-gather |
merge_reduce_scatter | reduce + scatter → reduce-scatter |
merge_reduce_broadcast | reduce + broadcast → all-reduce |
split_kernel 对一个 的 GEMM 有三种拆法:
| 拆法 | 展开后的子图 | 含义 |
|---|---|---|
| split-by-m | scatter → 多个 GEMM → gather | 按行切输入,各自算一部分输出行 |
| split-by-k | scatter → 多个 GEMM → reduce | 按收缩维切,各自得到部分和,再求和 |
| split-by-n | broadcast → 多个 GEMM → gather | 输入广播,按列切权重,各自算一部分输出列 |
每次变换都会重新计算受影响算子的 FLOPs、字节数、张量形状和通信量。
这些原语可以组合出常见的架构选择:
- PD 分离:用两个放置原语把 prefill 和 decode 的计算及交换的状态放到不同设备上。
- KV cache 生命周期:
dup/dedup_kernel控制 KV 重算与缓存的粒度;插入或删除ToNvme/ToDram/ToHbm恒等算子来描述 KV 在哪一层存储。 - 各种并行:
split_kernel、放置原语和通信合并原语组合出 TP、CP、DP、EP、PP。
用原语推出 Megatron 式张量并行(阅读推导,非论文原例)
一个 MLP 有两个 GEMM:上投影 和下投影 。
- 上投影用 split-by-n: 广播到各卡,每张卡算 的一部分列,结果 gather。
- 下投影用 split-by-k:它的输入 按收缩维(正好是上一步切开的那一维)scatter,每张卡算部分和,最后 reduce。
- 中间出现“gather 后紧跟 scatter,切分维度相同”,
merge_gather_scatter把它换成卡内直连,激活值不再离开本卡。(中间的逐元素激活需要随之按同一维切开,论文没有列出对应的原语。)- 下一层需要完整输入,末尾的 reduce + broadcast 由
merge_reduce_broadcast合成一次 all-reduce。结果正是“列切 + 行切 + 每个 MLP 一次 all-reduce”的标准张量并行。每一步都是带前提的局部改写,所以语义不变;AI 只要按这种方式组合原语,就能提出新的切分方案,而不必相信它自己写的并行代码是对的。
评估器:roofline 离散事件模拟
模拟器按拓扑序执行打好标签的计算图:一个 kernel 的所有数据前驱和控制前驱都完成、并且它被分配到的 stream 空闲时,就放行。开始和完成事件放进优先队列。每次完成都会更新后继是否就绪、张量是否还活着、资源是否被占用,所以得到的 trace 是受依赖约束的执行过程,而不是各算子耗时的简单相加。
单个算子的耗时分三部分算,取最大者,即假设计算、访存、通信完全重叠:
是 dtype, 是设备在该精度下的峰值。集合通信用 α+β 模型:α 取参与 rank 之间的最长路径延迟,β 是根据拓扑启发式估计的聚合带宽。
资源争用。 多个算子同时占用一个计算设备或一条链路时,每个算子按容量加权分得份额 。在共享期间,各算子的耗时按比例拉长,直到共享的算子集合发生变化。
显存。 输入、输出和权重的占用随算子的进入和退出事件记账;模拟器报告每个存储设备的峰值活跃字节数,超过容量就报告 OOM。
AI 架构师的循环
人:提供已验证的计算图(某模型)+ 硬件图 + 初始架构
  │
  ▼
agent 读 RoofLang 源码、现有实现和基线结果
  │
  ├─▶ 提出新的放置 / 图变换(只能用上面的原语)
  │       │
  │       ▼
  │   模拟 → 吞吐–交互性 Pareto 前沿 + trace(哪个阶段在关键路径上、哪段通信暴露)
  │       │
  └───────┘  根据 trace 修改方案,直到 agent 自己决定停止
实现上,这个 agent 就是在非交互模式下持续运行、不设轮数上限的 Claude Code,按 DeepSeek 官方集成方式把主模型换成 DeepSeek V4 Pro,子 agent 用 DeepSeek V4 Flash。agent 的任务是改进 RoofLang 里 DeepSeek V4 Pro 的实现,不断寻找能推进 Pareto 前沿的新放置和新变换。
3. 应用与效果
四个模型的解码上限
实验用四个 MoE 模型:DeepSeek V4 Flash(284B 总参数,13B 激活)、GLM-5.3(744B,40B 激活)、DeepSeek V4 Pro(1.6T,49B 激活)、Kimi K3(2.8T,104B 激活)。硬件是 H200、GH200、B300、GB300。扫描空间:prefill 和单步 decode,上下文 64K 或 1M,8 或 64 张卡,DP×CP=EP,batch 从 1 开始翻倍直到 OOM。
在 64 张 GB300 上,DeepSeek V4 Flash 的峰值解码吞吐是 GLM-5.3 的 9.6×(64K 上下文)和 16.7×(1M),是 Kimi K3 的 25.2× 和 39.5×;V4 Pro 对这两者是 3.5×–12.4×。总参数量解释不了这个差距。作者用每个解码 token 的显存流量来解释:
是权重字节数, 是每个请求每步要读的 KV 字节数, 是 batch 大小。解码受显存带宽限制,所以峰值吞吐大致与 成正比。64K 上下文的数据如下(论文表 7):
| 模型 | 每请求 KV 占用 | 每请求每步 KV 读取 | 峰值 batch | 每 token 显存流量 |
|---|---|---|---|---|
| DeepSeek V4 Flash | 0.192 GiB | 0.033 GiB | 65,536 | 0.035 GiB |
| GLM-5.3 | 2.906 GiB | 0.250 GiB | 4,096 | 0.419 GiB |
| DeepSeek V4 Pro | 0.275 GiB | 0.055 GiB | 32,768 | 0.079 GiB |
| Kimi K3 | 1.065 GiB | 1.065 GiB | 8,192 | 1.237 GiB |
KV 设计通过两条路径起作用:
- KV 占用小,batch 就能开大,权重流量 摊得更薄。V4 Flash 的 batch 能开到 65,536,权重流量摊到每个请求只剩 2.3 MiB。
- 每步只读一部分 KV, 直接变小。V4 的 KV 占用是 0.192 GiB,但每步只读 0.033 GiB;Kimi K3 两者相同,说明每步都要读全部状态。
两项都小的模型才能有极低的每 token 流量。
另外两个观察:prefill 的吞吐上限大致是“模型 FLOPs / GPU 峰值”,decode 的交互性上限大致是“每步激活参数字节 / HBM 带宽”。更大的 NVLink 域对 MoE 路由流量大的场景更有帮助;上下文变长时,attention 占比上升、batch 变小,路由流量占比下降,更大的 scale-up 域收益也随之变小。
agent 找到的三种架构
| 场景 | agent 做了什么 | 提升(吞吐和交互性同时) |
|---|---|---|
| decode-64K,256 张 B300,batch 4096,EP=16,PP=16 | 考虑首尾开销的 PP 切分:只按层数平均分会让带 embedding 的第一段和带输出头的最后一段成为瓶颈。agent 从 trace 校准每段的开销,枚举合法的连续切分,把 61 层从 改成 | 20.3% |
| prefill-8K,8 张 B300,batch 512 | 按 DP–CP 拆分路由专家:对专家的上下投影用 split_kernel,按已有的 DP×CP token 分片给每个分片一份副本,于是切分维度相同的 gather–scatter 可以换成卡内直连。代价是多读专家权重,所以只在每份至少有 1,024 个 token 且 EP ≤ 8 时启用 | 6.23% |
| prefill-1M,16 张 B300,batch 1,CP=EP=16 | 节点内复制专家:把部分专家在 EP=16 的两台机器上各放一份,路由的 dispatch/combine 走机内 NVLink 而不是跨机 InfiniBand。用 HBM 容量和权重读取换通信,只在通信受限时使用 | 50.1% |
三个方案有一个共同点:它们都在用资源换瓶颈(多读权重、多占显存),并且带着启用条件。这些正是需要看 trace 才能找到的权衡。
论文没讲清的
- 贡献中说会“比较 AI 驱动的探索与启发式网格搜索”,但正文只报告了 agent 找到的三个案例,没有给出网格搜索与 agent 的系统比较,也没有 agent 运行的会话数、时长、token 花费和失败方案的比例。
- agent 案例的设置(256 卡、16 卡、8K 上下文)不在第 3.1 节的扫描空间里(8/64 卡、64K/1M),这些场景的基线怎么确定没有说明。
- “保持语义”靠的是人写的改写规则及其前提条件,没有形式化证明。规则本身写错了怎么办,论文只说初始输入和变换约定仍需人工验证。
- agent 是否会写出原语以外的东西(比如直接改模拟器或成本公式),论文没说如何约束;第二个案例中的启用阈值也像是 agent 自己加的规则。
- 集合通信的有效带宽“由拓扑启发式估计”,具体启发式没有给出。
证据边界
- 全文没有任何真实硬件的对照。 所有数字(3.5–39.5×、6.23–50.1%)都是 roofline 模型内部的结果,并且假设计算与通信完全重叠、MoE 负载完全均衡。Koi 报告过,即使用实测峰值校准,roofline 模型的误差也可达 4.7×。
- 模型做了简化:没有 KV 追加、推测解码结构、DeepSeek V4 的 mHC、Kimi K3 的多模态部分。
- H200/GH200 不支持原生 FP4,论文假设它们模拟 FP4 和 FP8 一样快,这对用 FP4 的模型(V4 系列、Kimi K3 的 FFN)有利。
- agent 只优化了 DeepSeek V4 Pro 一个模型,三个案例是作者挑出的“代表性”结果,50.1% 的那个是 batch 1、1M 上下文的极端 prefill。
- 模拟器扩展性差:在 128 卡上模拟 Kimi K3 要几个小时和几百 GB 内存,作者自己也承认这让反复的 agent 优化不现实。
对 CKG 的启发(阅读判断)
第一,把“架构上限”和“实现质量”分开记录。同一个性能结论,可能来自 roofline 上限,也可能来自某个栈的实测,两者含义不同:前者说明“值不值得做”,后者说明“现在做得怎么样”。知识条目应标明来源属于哪一层。第二,给 AI 的动作空间可以由带前提的原语组成,正确性来自原语,而不是来自 AI 本身。第三, 这样的分解是很好的可复用解释量:它说明了为什么总参数量不能预测解码吞吐,比单个吞吐数字更值得存。
相关:Frontier 也是离散事件模拟器,但它按具体服务栈实测校准,追求“决策级精度”,与 RoofLang 的“与实现无关”恰好相反;MLSYSIM 同样用第一性原理公式,但不提供图变换动作空间;SMART 也是符号化的 roofline 式性能模型,重点在于代码由设计文档重新生成;Glia 让 agent 在 Vidur 模拟器上设计服务策略。
依据:原文 v2,三要素与总览见第 2.1 节,计算图与硬件图见第 2.2–2.3 节,放置与变换原语见第 2.4–2.5 节(表 1、表 2),模拟器与成本公式见第 2.6 节,模型与硬件设置见第 3.1.1 节(表 3–6),解码上限分析见第 3.1.2 节(表 7、表 8),agent 实验见第 3.2 节,局限见第 5 节;代码见 GitHub;核对日期:2026-11-03。