Design Docs Are All You Need: An AI-native Machine-Learning Performance Tool
核心思路
ML 性能建模工具的抽象很快过时:今天“每层 Transformer 都一样”的假设,明天就被 MoE、潜在注意力、异构推理阶段打破,框架只能不停打补丁。SMART 的做法是不再维护代码:主分支几乎只有一组自然语言设计文档,组成一个依赖 DAG;每次版本更新时,由编码子 agent 按拓扑序只根据文档从零重新生成整个库,人类的所有修改都是对文档的自然语言修改。让重新生成可靠的有两点:一是文档里写满逐步推演的例子,并以精确的期望输出作为测试锚点;二是一个极小的、递归定义的算子 IR,成本用 SymPy 符号表达式表示,有一个快速的解析汇总模式和一个慢速的模调度模式。这是一篇 4 页的短文,几乎没有实验。
1. 背景与问题
性能建模框架夹在技术栈中变化最快的两层之间:上面是不断变化的模型架构,下面是不断变化的加速器和互连。两边的变化都要被它吸收,结果就是无休止的重构和临时补丁。与此同时,AI 编码 agent 已经快到“重写整个库”比“还技术债”更便宜。作者指出两种会不断累积的失败模式:
增量生成的债。 设 是 时刻库的规格, 是代码生成者(人或 agent)。从零构建是 。但实际上,下一版总是在旧代码上改:。技术债可以定义为两者的差距:
人很难下决心删掉所有代码重来,所以这个差距在实践中远大于零,每次修改规格时的妥协还会层层叠加。
上下文窗口的近视。 成熟代码库放不进一个 prompt,只能把局部片段喂给 agent。agent 看不到全局不变量、跨模块依赖和架构意图,写出的代码局部合理、全局次优,结构的一致性会一点点被侵蚀。
2. 方法与创新
设计文档是唯一的源头
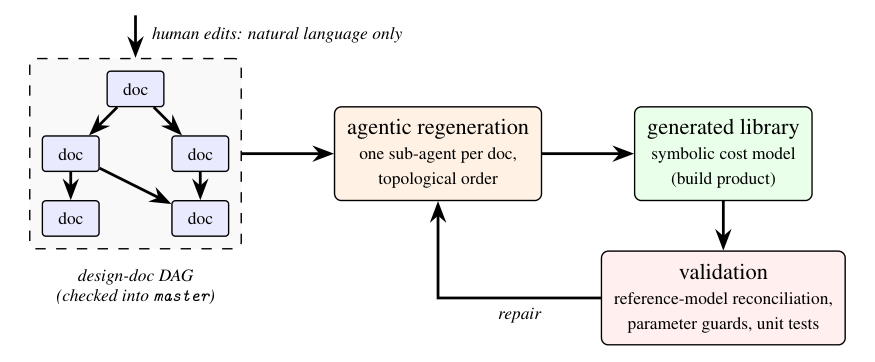
原论文图 1,v1 PDF 第 2 页。人类只用自然语言修改设计文档;文档组成 DAG 并提交到主分支;子 agent 按拓扑序、每篇文档一个,重新生成库;生成的符号成本模型是构建产物,必须通过与参考模型的对账、参数守卫和单元测试,否则返回修复;通过后才替换上一版构建。
主分支是一个目录树,里面是 markdown 设计文档,外加少量叶子工具函数。文档之间有生成顺序:硬件拓扑和数值精度要先于集合通信成本模型,后者又要先于模型目录。
| 环节 | 做法 |
|---|---|
| 依赖边 | 不手工维护,由一批只读 agent 阅读文档后推断 |
| 生成 | 编排 agent 按拓扑序一波一波推进,每篇自成一体的文档交给一个专门的编码子 agent |
| 日志 | 编排 agent 维护一个中央日志,记录子 agent 在哪里读不懂文档,以及后面几波中发现的前面几波的 bug |
| 验证 | 与人工核对过的参考模型对账、参数守卫、单元测试;不通过就修复 |
一篇文档对应一个子 agent,有三点好处:
- 上下文有界:每次生成只看一篇文档,任务短,正确率高。这直接针对上面的“上下文近视”。
- 人工迭代有的放矢:日志说明哪篇文档最难,即 agent 最常卡住、bug 最多的文档,人就知道下一版该把哪篇写清楚。
- 按难度分配模型:核心 DSL 这类基础文档交给大模型,许多下游文档用小模型就能翻译成正确代码。
成本。 一次完整的从零重建需要 1.5–3 小时,用 Claude Code 的 API 费用约 100 美元,约占 Claude Max 这类高档套餐每周额度的 20%。因此可以定期全量重建。重建是从头计算 ,按构造,上面的债 就是零。
怎么写文档:逐步推演的例子
常见做法是写好测试和高层规则,相当于给生成者一部“宪法”,这是自上而下的约束。作者认为还需要一个自下而上的要素:worked example。
把一段伪代码在具体输入上一步步执行:中间张量的形状、中间值、最后应该得到的闭式成本表达式。对生成代码的 agent 来说,这相当于上下文中的示范,能把纯文字说不清的语义钉死,让多次独立生成的结果保持一致。
论文举的例子是:在带回绕的 2×2×2 torus 上,每个节点的链路数是 3 而不是 6,因此 V 字节的 all-gather 的成本是……这个例子之所以重要,是因为每一维只有 2 个节点时,“正方向邻居”和“负方向邻居”是同一个节点,按通用公式算出 6 条链路就错了。一句抽象的“torus 每维两个邻居”无法提醒 agent 注意这种边界情况,一个算好的例子可以。
每篇涉及数值的文档最后都有一个对账锚点:一个小规模的预设配置,期望输出精确写明,并由生成的测试强制检查。
极小的符号 IR
可靠的重新生成也约束了被描述的对象:抽象要少、彼此正交、在架构变化下保持稳定。SMART 只有一个递归定义的 Op:
Op:
  inputs:  List[Tensor]     # 符号形状
  outputs: List[Tensor]
  cost:    OpCost           # 每类成本(计算、访存、通信)一个 SymPy 表达式
  rrt:     RRT              # 资源预约表:行 = 资源,列 = 周期,格 = 占用单位
  params:  InnerLoop(n_iter, body: Graph)   # 循环嵌套
         | GraphParams(graph)              # 子图
         | LeafParams(...)                 # 叶子算子
一个 Op 要么是内部节点(一个带迭代次数和循环体的循环,或一个普通子图),要么是叶子。叶子是软件和系统的交界:系统一侧为每个叶子给出 RRT 和成本。作者的目标硬件是 TPU,所以叶子是 TPU 形状的:MXU 矩阵乘 tile(mxu_op)、把 tile 读进 VMEM(load_tile_to_vmem)、ICI 集合通信(allgather)。
算法一侧把叶子组合成循环嵌套,系统一侧给叶子定价。换一种注意力变体只改算法侧的文档,换一代互连只改系统侧的文档。
建模 DSL
模型用一个嵌在 Python 里的追踪式 DSL 编写,从不手工构造 Op:
- 被装饰的代码块追踪成一个具名子图;
@smart_loop是真正的归约循环,带累加器;@smart_map_loop是并行 map;两者都变成InnerLoop;- builder 调用(
b.load_tile、b.mxu_op……)生成由系统侧定价的叶子; - 所有维度都是 SymPy 符号,
T_q/q_blk这样的迭代次数保持符号形式,一次追踪覆盖整个设计空间。
论文的 flash-attention 例子(略有精简):
def flash_attention_core(b, q, k, v, *, B, H, T_q, T_kv, hd_qk, hd_v, q_blk, kv_blk):
    @smart_map_loop(b, n_iter=T_q/q_blk, name="q_blocks", gather_axis=2)
    def q_block():                                   # 对 query tile 并行 map
        q_i  = b.load_tile(q, (B, H, q_blk, hd_qk))
        acc0 = b.load_tile(v, (B, H, q_blk, hd_v))
        @smart_loop(b, n_iter=T_kv/kv_blk, name="kv_blocks")
        def kv_block(o_acc):                         # 对 kv tile 归约
            k_t = b.load_tile(k, (B, H, kv_blk, hd_qk))
            v_t = b.load_tile(v, (B, H, kv_blk, hd_v))
            s   = b.mxu_op("bhte,bhse->bhts", q_i, k_t, name="scores")
            pv  = b.mxu_op("bhts,bhse->bhte", s, v_t, name="attn_v")
            return b.tensor_add(o_acc, pv, name="accumulate")
        return b.store_tile(kv_block(acc0))
return q_block()的分数矩阵始终留在 VMEM 中。 和 分开,所以同一个循环嵌套既能描述 prefill(),也能描述 flash-decoding()。
分布式用分片标注,而不是手写通信。 张量标明每一维切在哪个 mesh 轴上,分片 einsum 包装器根据操作数和输出的分片推断需要的集合通信:收缩维的权重被切开时,及时插入 AllGather;输出在被切开的维上做了归约时,插入 ReduceScatter。只有改变布局的集合通信需要显式写出:在 DeepSeekMoE 块里,dispatch 的 all-to-all 把专家并行轴从 token 组维移到专家维,combine 再移回来;块里其余的通信全是推断出来的。
两种汇总模式
| 模式 | 怎么把一棵 Op 树变成时间 | 用途 |
|---|---|---|
| 快速 | 每个叶子的成本乘以外层所有循环的迭代次数;用简单的解析调度器把计算/通信重叠(权重预取、all-to-all 隐藏)表示成可组合的变换,类似 roofline 界 | 闭式求值,能扫上千个设计点 |
| 慢速 | 每个循环按其 RRT 做模调度(software pipelining):在每种资源的容量约束下让相邻迭代重叠,求出能达到的启动间隔(initiation interval),再递归地往上汇总 | 对扫描中挑出的有趣设计点,给出考虑依赖和资源的精细调度 |
符号传播。 所有成本公式都以符号形式向上传播,每次汇总得到的都是设计空间自由变量(batch、序列长度、带宽、mesh 轴、数据类型宽度)的闭式 SymPy 表达式。只在最后一步代入数值,每个设计点一次代换,所以一次符号构建就够整个扫描使用。文档甚至可以直接写出某个集合通信成本的精确期望表达式,由生成的测试来断言。
快速模式在 flash-attention 上算出什么(阅读推导,非论文原例)
scores这个叶子每次迭代的 FLOPs 是 。快速模式乘上两层循环的迭代次数 ,得到 ,tile 大小消掉了,与教科书上的注意力 FLOPs 一致。访存就不一样了:
k_t每次读 个元素,乘上同样的迭代次数,得到 。也就是说,K 要被完整读 遍。这个式子直接说明了“query tile 越大,K/V 重复读得越少”,而且因为整个表达式是符号的,可以直接对 求最优,或代入 decode 的 看到重复读取消失。这正是符号 IR 相比“跑一遍得到一个数”的好处。
论文没讲清的
- 摘要说重新生成的实现能把人工核对过的参考模型(包括 DeepSeek-V3 在 TPU pod 切片上的服务)复现到舍入误差级别,但正文没有任何表格或数字,不知道对了哪些量、多少个模型。
- 没有报告重新生成的失败率:一次重建需要几轮修复?哪些文档最常出错?日志中发现的问题有多少?
- 依赖于 是确定的。agent 每次生成的代码都不同,同一组文档两次生成的结果是否一致,测试锚点只能约束被测到的点。论文没有讨论这种方差。
- 技术债可能只是从代码转移到了文档:文档本身也是被人一次次增量修改的。文档层面如何避免同样的累积,没有讨论。
- 模调度模式与快速模式的结果差多少、慢速模式要跑多久,没有给出。
证据边界
- 这是一篇 4 页的短文,正文没有实验部分。可以确认的只有规模和成本:50 篇文档、约 9,000 行规格文字,覆盖 TPU 拓扑、集合通信成本、数值、调度器以及稠密、MoE、潜在注意力、机器人/VLA 等模型族;一次重建 1.5–3 小时、约 100 美元。
- “参考模型”本身也是人工搭建的解析模型,对账检查的是“生成代码与人写模型一致”,不是“与真实 TPU 的测量一致”。性能模型本身的准确度没有报告。
- 只有一个库、一个团队的经验;方法能否推广到其他“规格变化比软件快”的领域,结论部分只是作者的判断。
对 CKG 的启发(阅读判断)
这篇最值得借鉴的是文档的写法。一条知识如果附带一个算好的小例子,并写明精确的期望输出,就同时满足了三件事:人读得懂;agent 可以把它当作上下文示范;机器可以把它当作测试来检查。torus 链路数的例子说明,边界情况最好用例子而不是抽象规则来表达。另外,“编排日志记录 agent 在哪篇文档上卡住”是一种廉价的质量信号:哪条知识最常被误读,就最该重写。
相关:RoofLang 同样用解析的 roofline 式成本模型,但重点在于给 AI 一个保持语义的架构变换空间;MLSYSIM 也把性能建模写成可组合的第一性原理公式;Simthesizer 让编码 agent 按需求扩展服务模拟器,SMART 则让 agent 从文档重新生成整个库。
依据:原文 v1,两种失败模式与技术债公式见第 1 节,设计文档 DAG、编排流程、成本与 worked example 写法见第 2 节,Op IR、建模 DSL、分片推断、两种汇总模式与符号传播见第 3 节,规模见第 4 节;核对日期:2026-11-03。