Simthesizer: An Agent-Driven Simulation Framework for LLM Serving Systems
核心思路
LLM 服务技术更新太快,人工维护的模拟器追不上;而 agent 工作流、P/D 分离、推测解码等新机制又打破了模拟器固定的“单次推理”流水线。Simthesizer 双管齐下:模拟器把整个服务流程(包括路由、组 batch 等控制决策)统一表示成可在运行时增长的 DAG,并把策略拆成可替换的组件;再由一个带约束的编码 agent,把自然语言功能需求逐步落实为规格说明、实现映射与代码,并对照真实系统验证。新功能因此是局部扩展,而非重写模拟器。
1. 背景与问题
模拟器是探索 LLM 服务设计空间的常用工具:真机实验昂贵,未上市的加速器也无法实测。Vidur、APEX、LLMServingSim 等已有模拟器各有抽象,却共享两个前提:
- 服务系统演化得足够慢,人工实现新机制的成本可以摊销;
- 服务行为可以写进一条固定流水线:请求到达 → 调度 → 推理 → 完成。
这两个前提正在失效:
| 变化 | 例子 | 对模拟器的冲击 |
|---|---|---|
| 快速演化 | 推测解码从 draft-verify 发展到树状、suffix decoding;服务架构从单体走向 P/D、Attention–FFN 分离 | 新机制出现得比人工实现快,模拟器与真实系统的差距越来越大 |
| 非单体服务 | agent 请求由多次推理、工具调用、子 agent 交织组成;P/D 分离中间插入 KV cache 传输 | 超出固定流水线的功能都要改动控制流,牵一发而动全身 |
直接给现有模拟器配一个编码 agent 也不够:模拟器结构耦合,agent 的修改照样是大范围重写,难以审查,也可能悄悄引入退化;能编译、能通过测试的代码,仍可能模拟了错误的系统。由此作者提出两条原则:
- 原则 1:可组合的统一表示。用同一种表示刻画阶段、依赖与状态转移,扩展时只需增加与组合组件。
- 原则 2:受约束的 agent 实现。限定 agent 的修改范围,并加入模拟器专用的检查与针对模拟语义的验证。
2. 方法与创新
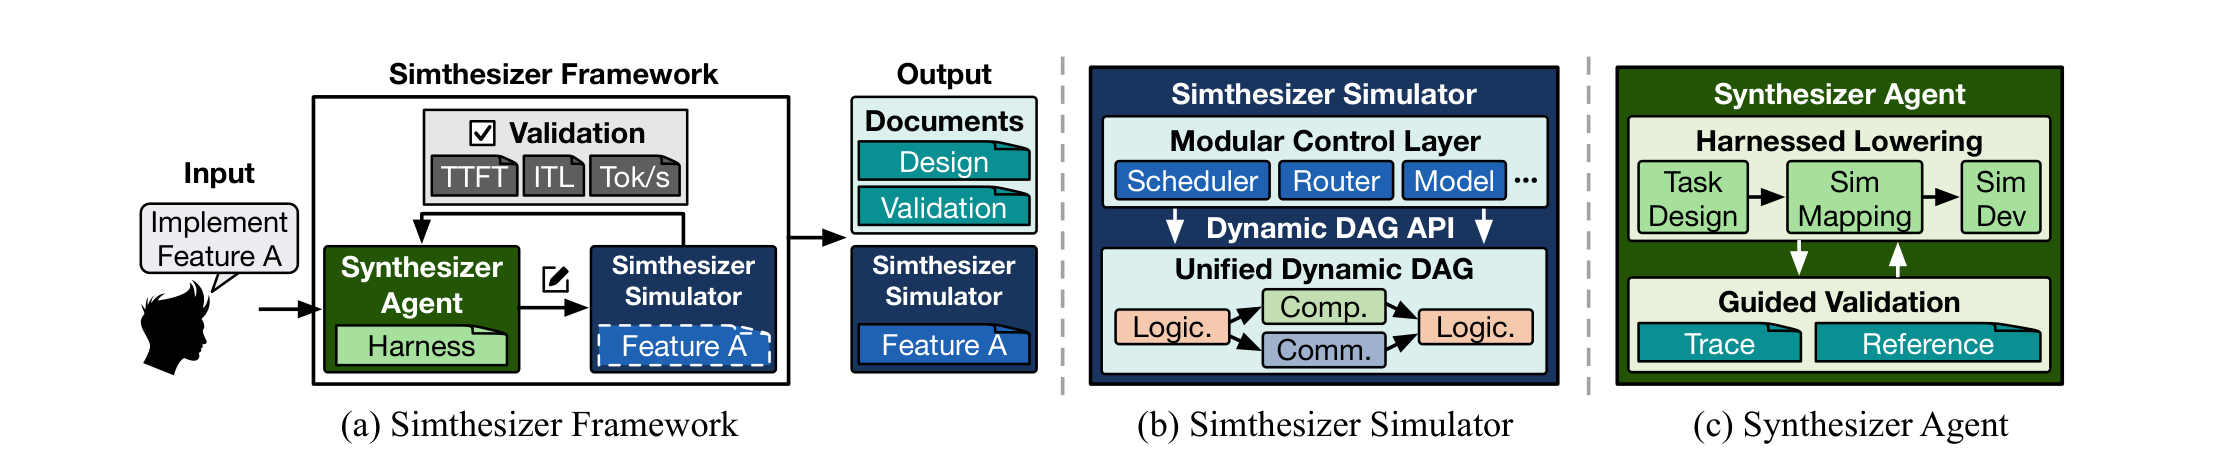
原论文图 3,v2 PDF 第 4 页。a 是总流程:用户需求 → agent 扩展模拟器 → 按 TTFT、ITL、吞吐验证 → 输出新模拟器与设计、验证文档;b、c 分别展开两个组件。
模拟器:统一动态 DAG
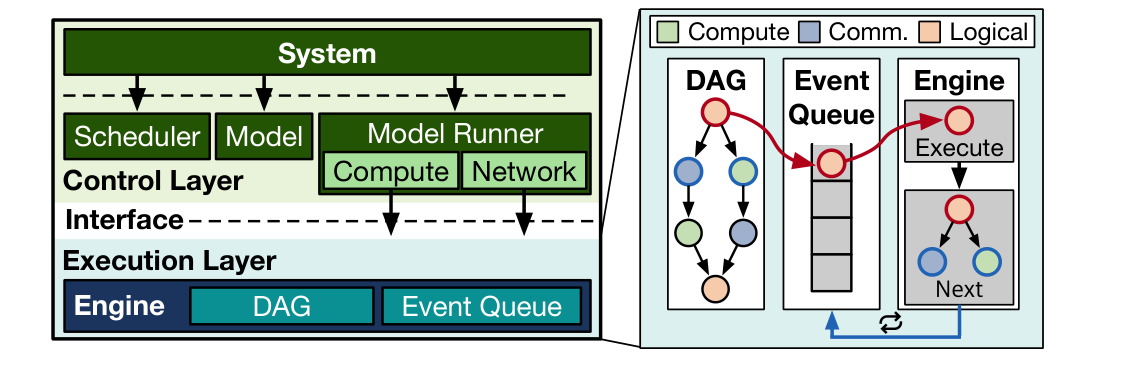
原论文图 4,v2 PDF 第 4 页。上层组件通过接口生成 DAG 节点,下层引擎按事件队列执行,执行逻辑节点时可能继续扩展 DAG。
整个模拟执行被表示为一张 DAG,有三类节点。作者用两个维度区分它们:时延是否在派发时即可确定,执行是否会改变后续状态。
| 节点 | 表示什么 | 时延 | 状态 | 处理方式 |
|---|---|---|---|---|
| 计算节点 | 某个模型算子在某个设备上执行 | 确定 | 无状态 | 由算子、batch 和设备模型给出一个时延 |
| 通信节点 | 设备间传输 | 不确定(链路竞争) | 无状态 | 资源状态变化时,网络模型可作废原完成事件并重新排期 |
| 逻辑节点 | 请求到达、路由、组 batch 等决策 | 确定 | 有状态 | 更新请求或系统状态,并可改写 DAG |
关键创新在逻辑节点:已有模拟器的 DAG 只含计算与通信,控制决策写在 DAG 外的固定流程中;Simthesizer 把决策也变成图中的一等节点。执行引擎是统一的事件驱动循环:取出最早事件、推进时间、处理节点、通知后继节点,然后将新就绪的节点入队。
逻辑节点通过 Dynamic DAG API 在运行时扩展图:
| API | 作用 |
|---|---|
add_logical_node / add_compute_node / add_network_node | 按类型新建节点 |
add_edge(parent, child) | 声明先后约束 |
pop_edges(node) | 摘下某节点的出边,以便在它与原后继之间插入子图 |
例:P/D 分离时,decode 被分配到另一台机器,就用 pop_edges 摘下 prefill 的出边,插入 KV cache 传输节点,再把 decode 接在它后面。只改动局部,图的其余部分不受影响。
模块化控制层负责“由谁来改图”。如果一个处理器包揽所有决策,就又成了单体流水线。因此:
- 组件负责角色:路由、调度、模型执行等各由一个组件处理自己的逻辑节点;
- 接口固定角色:例如
Scheduler只有enqueue_sub_request和schedule,具体策略可以替换; - 实现封装状态:队列、缓存元数据、参数都留在实现内部;
- 配置组合系统:用
kind字段选择实现,如在SingleInstance下使用开启前缀缓存的ChunkedPrefill。
于是扩展的代价有了上界:所需策略都已存在时只改配置;缺一个策略时,只实现这一个组件。
内置七类组件接口,沿请求路径依次是路由、系统编排、batch 调度、模型执行、模型描述、计算计时、网络计时;内置实现覆盖单/多实例、P/D 分离、专家并行 MoE、chunked prefill 与前缀缓存等。计时后端可插拔:默认计算后端查离线 profile 表(每类层至多两个键,例如 attention 的 KV 规模与 query–context 交互数),默认网络后端按 flow 粒度建模,每条流取路径上的最小可用带宽。
Synthesizer agent:带约束的“降级”流程
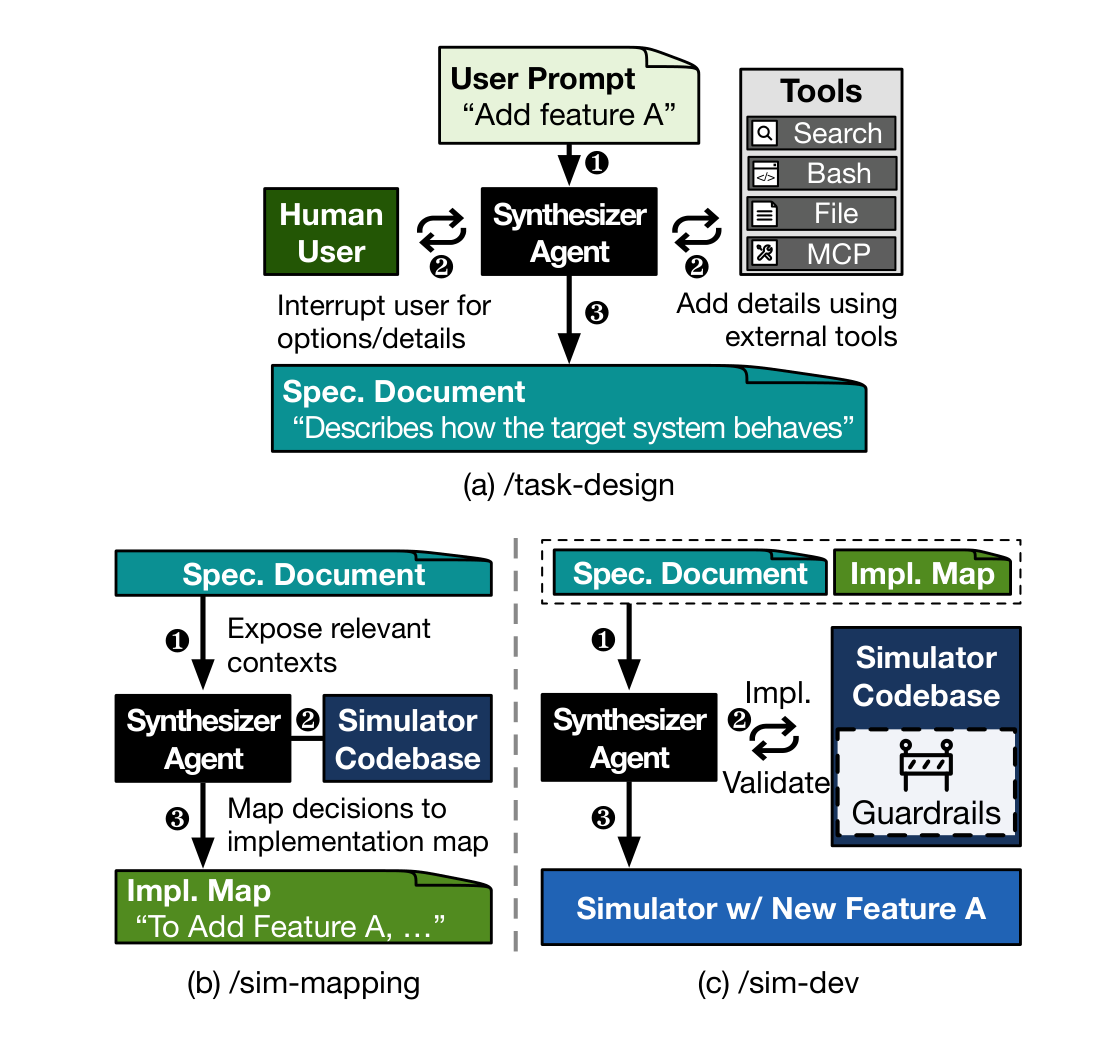
原论文图 6,v2 PDF 第 7 页。每个阶段产出一份文档,后续阶段以它为输入。
这里的 lowering 借用了编译器术语:把高层的自然语言需求逐层翻译成可执行的模拟逻辑。作者提出三项要求,分别由三个阶段负责:
| 阶段 | 满足的要求 | 产物 |
|---|---|---|
| task-design | 语义完整:决定模拟时间、资源竞争、状态生命周期、依赖结构和指标边界的选择,要么写进规格,要么明确提交人类决定 | 规格文档(spec) |
| sim-mapping | 结构对齐:每个建模决策对应到负责它的组件、接口或 DAG 操作,不散落在无关代码路径中 | 实现映射(impl map) |
| sim-dev | 建模保真:实现并迭代;近似必须声明假设、证据和适用边界 | 代码与验证报告 |
**模拟器专用的检查规则(guardrail)**会拦截三类问题:未声明的近似、来历不明的常数、偏离实现映射的改动。问题按出处回到相应阶段:映射错了回到 sim-mapping,代码 bug 留在 sim-dev 内修复;遇到影响性能的关键歧义时,agent 应询问人类,而不是自行选默认值。
验证分两种:
- trace 引导:有真机测量时,在相同负载、配置与硬件下对比,并对齐队列长度、batch 组成、资源利用率等内部信号,定位哪个建模决策导致偏差;
- reference 引导:没有真机时,依据参考实现与已发表结果检查行为是否合理。它不能证明与目标系统一致,但能暴露剩余假设与不确定性。
案例:加入 EAGLE-3 推测解码
task-design 从参考算法中提炼出四个语义变量:剩余输出长度 、验证宽度 、接受的草稿数 、实际推进量 。难点在于分清目标模型做了多少计算( 个位置)和请求实际前进了多少( 个 token)。
扩展没有新增事件、节点类型、图 API 或执行循环,只改动了请求状态与调度相关的少数组件。首轮候选版本高估吞吐 13.4%;对照 trace 发现,它只在最后一层用了 ,其余层按 个位置计算,因而低估了计算量。修正语义后,吞吐偏差降到 6.7%,聚合吞吐只低估 4.7%。验证把一个“数值偏差”转化为一条可修正的语义错误。
3. 应用与效果
实验平台为 2 张 RTX Pro 6000 Blackwell,真实系统用 vLLM 0.19.1;Synthesizer agent 默认是 Codex 中的 GPT-5.4(xhigh)。对比对象 LLMServingSim2.0 和 Vidur 使用相同的编码 agent、harness、提示、规格与 profile 数据,分别在各自代码上实现同样的功能。
| 问题 | 设置 | 结果 |
|---|---|---|
| Q1 复杂负载 | 未经扩展的 Simthesizer;mini-SWE-bench、tau-bench 两种 agent 负载;Llama3.1-8B 与 Qwen3-30B-A3B | 吞吐误差 0.20%–4.54%;平均 TTFT 误差较大(最高 21.87%)。MoE 偏差更明显,因为专家路由用统计量估计 |
| Q2 扩展保真 | FP8 KV cache 量化、EAGLE-3 推测解码、混合 Mamba 模型三项新功能 | 平均吞吐误差 2.51%,基线上实现同样功能为 6.03%;KV 量化三者都准,差距主要在后两项 |
| Q3 harness 作用 | 推测解码,有无 harness | 去掉 harness 后误差升高 1.65×–3.69×,如 TPOT 1.55% → 5.71% |
| Q4 模拟速度 | ShareGPT 负载 | 平均比 LLMServingSim2.0 快 164.9×(最高 284.96×),比 Vidur 快 6.65×(最高 23.19×) |
| Q5 换 agent | Claude Code(Opus 4.7) vs Codex | 四项指标平均误差 4.9% vs 4.1% |
Q3 中 harness 的作用被归结为:提供知识库,规格未定之前阻止开始实现,并强制自我验证。没有它时,agent 常常忽略关键系统细节,规格不完整就动手写代码。
证据边界
- Q1 检验的是基础模拟器,tool call 的时延是在真机上预先执行后回放的,并不检验 agent 扩展能力。
- 基线上的扩展同样由 agent 完成,而不是由原作者人工实现;速度差距主要反映“扩展代码放在哪里”,不等于基线模拟器原生更慢。部分作者也是 LLMServingSim 系列的作者。
- 只覆盖三项扩展任务、一种 GPU 平台;“多次独立试验”的次数和方差未详细报告。混合 Mamba 因各层逐个模拟而较慢。
- reference 引导的验证只能说明“与已有证据相符”,不能替代真机测量。
对 CKG 的启发(阅读判断)
“规格 → 实现映射 → 验证报告”的三件套,相当于为每次模型扩展保存可审计的推导链:做了什么假设、对应到哪个组件、用什么证据验证、偏差落在哪个决策上。尤其值得借鉴的是:把近似、常数和适用边界作为必须显式声明的字段;验证失败时,按决策出处回溯,而不是笼统地“再改一次代码”。
相关:Glia 在 Vidur 上让 agent 设计服务策略,MLSYSIM 则用解析公式而非事件模拟分析系统瓶颈。
依据:原文 v2,动机与两条原则见第 II 节,模拟器设计见第 IV 节,agent 流程与验证见第 V 节,推测解码案例见第 VI 节,实验见第 VII 节;核对日期:2026-10-28。