LLM-SR: Scientific Equation Discovery via Programming with Large Language Models
核心思路
LLM 根据科学背景提出“可能长什么样”的公式程序,数值优化器用数据拟合其中的参数。高分公式再作为示例,帮助 LLM 继续改进结构。结构搜索与常数拟合分开,是本文最值得借鉴的设计。
1. 背景与问题
符号回归希望从数据中发现可解释公式。困难不只是选几个系数,而是决定使用加法、乘法、指数、三角函数等哪些结构;组合空间巨大。传统方法主要在表达式空间搜索,对问题的科学含义利用有限。
LLM 知道一些机理,例如振子可能包含驱动力、阻尼和恢复力,但让它直接写出完整公式与所有常数,并不能保证拟合正确。LLM-SR 用领域先验缩小结构探索,再让数据评价候选。
2. 方法与创新
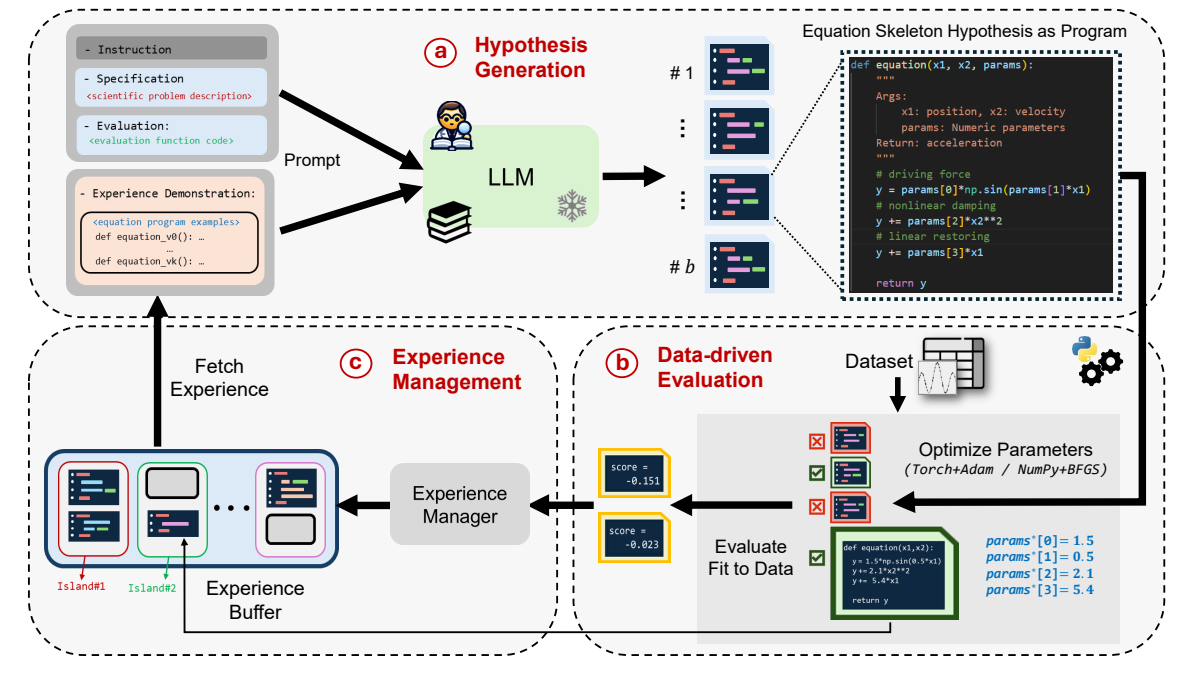
原论文图 1,v3 PDF 第 2 页。右上角生成含参数占位符的程序,右下角用数据拟合,左侧经验池保存可用于下一轮的候选。
用程序表示公式骨架
输入包含问题说明、变量含义、评估函数,以及已经找到的公式示例。LLM 生成形如 f(x, params) 的 Python 函数:运算结构由模型决定,待估常数通过 params 留给优化器。
例如下面是解释这种分工的示意,并非论文恢复出的某条最终公式:
“周期驱动、非线性阻尼、交互项、恢复项”属于结构; 是待拟合参数。程序形式比单棵表达式树灵活,也便于使用 NumPy 或 PyTorch。
对每个骨架单独拟合与评分
用自己的记号概括其内外两层任务:
内层使用 NumPy + BFGS 或 PyTorch + Adam,外层由 LLM 和进化式搜索探索程序结构。执行失败、超时的候选会被丢弃;低拟合误差也不自动证明机理正确。
用多样的经验池引导下一轮
系统维护多个 island,将候选按行为和分数组织,采样高质量且多样的程序放入上下文。LLM 据此修改或组合公式,既利用已有成果,也保留探索空间。本文的闭环是:提出结构 → 拟合参数 → 数据评分 → 更新示例 → 再提出结构。
3. 应用与效果
论文设计四个问题:两个定制非线性振子、改造后的大肠杆菌增长模型,以及铝合金应力—应变真实实验数据。这样做是因为常见 Feynman 公式可能已在 LLM 训练中出现,仅复述已知公式不足以证明发现能力。
表 1 使用归一化均方误差 NMSE,越低越好。下面摘录分布外测试结果:
| 方法 | 振子 2 OOD NMSE | 大肠杆菌 OOD NMSE |
|---|---|---|
| PySR | 0.0098 | 1.0141 |
| uDSR | 0.0015 | 5.4584 |
| LLM-SR,GPT-3.5 | 0.0264 | |
| LLM-SR,Mixtral | 0.0291 | 0.0037 |
不同底座各有强项,不能说某个版本在每项都最好。论文约用 2.5K 轮搜索,对比搜索式基线的 2M 以上轮数;候选评估成本不同,迭代数不能直接换算成墙钟加速比。
关键消融见第 3.5 节:在振子 2 上,让模型直接生成含数值的完整公式、取消独立参数优化后,OOD NMSE 升至约 0.375;移除迭代反馈也明显恶化。这比只看最终最优公式更直接地支持了“先验提结构,数据定参数”的分工。
证据边界
主要基准只有四个问题,其中三个是定制合成任务。OOD 表现支持这些测试范围内的外推,没有保证任意物理系统上的规律发现。符号回归从观测数据找到可解释函数,也不自动识别干预因果关系;单位一致性和适用范围仍需额外检查。
对 CKG 的启发(阅读判断)
一个机理应保存“输入变量集合 → 输出”的函数及参数,而不只是某一条边的权重;有多父节点、乘积项或分段行为时,单个系数尤其不够。可为知识条目增加函数形式、参数拟合数据、单位、适用区间、验证误差和版本。这是一项结合本文与工程需求的设计建议,论文自身没有提出完整的 CKG 条目格式。
相关:Linear-LLM-SCM 直接检验“不给数据,让 LLM 填系数”。
依据:原文 v3,方法见第 2 节,基准、结果和消融见第 3 节;代码与数据。预印本始于 2024 年,笔记按 ICLR 2025 会议年份归档;核对日期:2026-10-24。