Linear-LLM-SCM: Benchmarking LLMs for Coefficient Elicitation in Linear-Gaussian Causal Models
核心思路
已知因果图、变量含义、单位和范围,但不给观测数据,让 LLM 填线性结构方程的系数,再与已有参数比较。实验发现数值误差、重复调用不稳定及结构扰动敏感性,提醒我们不要把合理解释直接当作可用参数。
1. 背景与问题
知道“某因素会影响某结果”,与知道“提高一个单位会改变多少”,是两种能力。LLM 可能说清影响方向,却不知道特定人群、硬件或环境里的效应大小。
本文刻意隔离参数问题:DAG 已经给定,不评估因果图发现,也不要求模型从测量数据拟合。它检验模型能否仅凭训练中可能吸收的知识、变量语义和范围,提供可信的定量关系。
2. 方法与创新
在线性高斯设置中,每个节点写成:
系统按拓扑顺序遍历图,每次把一个节点和它的直接父节点交给 LLM,要求输出解释和可解析的方程,最后拼成完整参数集。
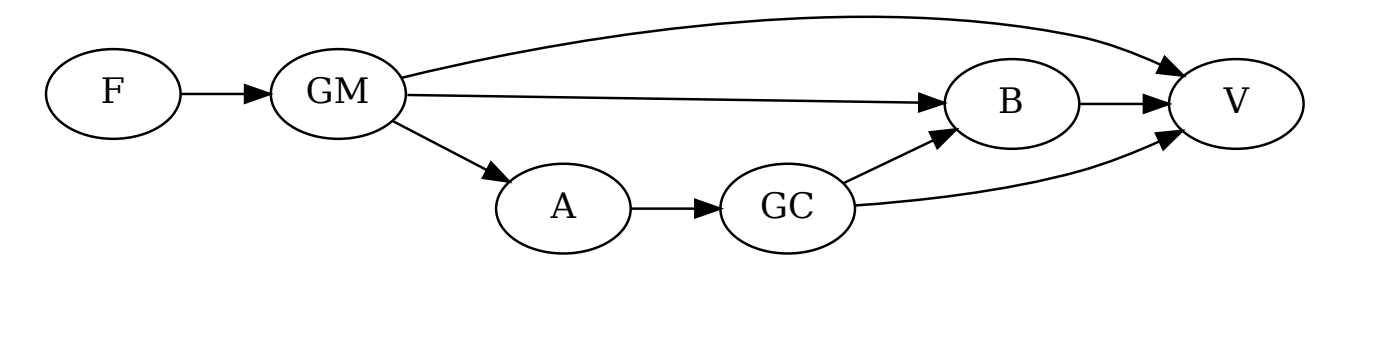
原论文图 6,v2 PDF 第 18 页。这里节点与箭头是输入;任务是为对应结构填参数,不是从图中发现新的机制。
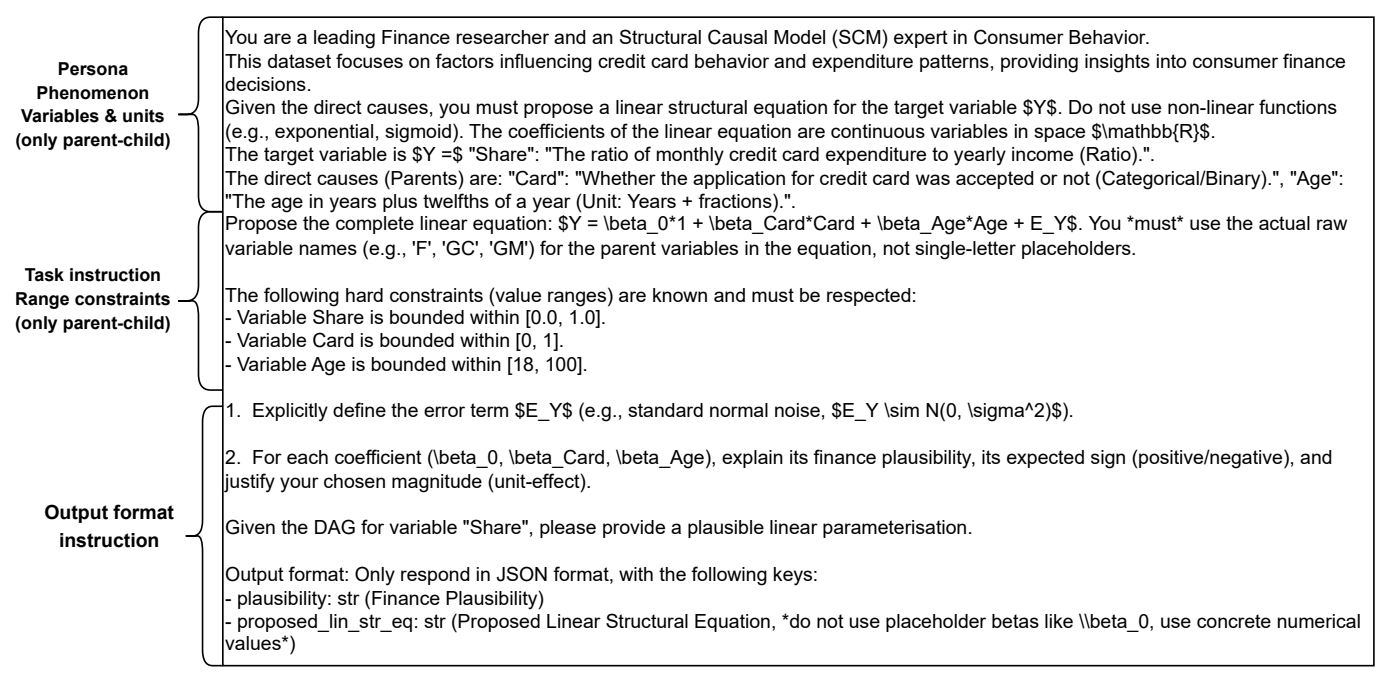
原论文图 3,v2 PDF 第 17 页。图中是金融变量示例;输出虽然包含合理性解释,评测仍必须核对数值。
候选方程还经过范围检查:若父变量在给定区间内变化,会不会把目标推到硬边界外?不通过就把失败原因反馈给 LLM 重试。该检查只能过滤部分不合理结果,满足值域约束不等于系数准确。
评估不仅看原始 L2 距离,还看归一化误差与同一子节点内的效应相对排序。M1 容易被变量量级支配;M3 排除单父节点项后比较归一化向量;M4 统计相对排序的正确数量,不能当作不同图之间统一的准确率。
3. 应用与效果
从 BnRep 选出 7 个真实领域的线性高斯网络,最多 15 个节点,覆盖代谢、消费支出、粮食安全、藻类、词汇、液化沉降、股票等情境。对四个 LLM,每个条件重复 25 次,温度设为 0。
| 检验 | 观察 | 含义 |
|---|---|---|
| 直接估计 | 不同图上的最优模型不同,多项误差仍明显 | 没有稳定通用的定量参数来源 |
| 重复调用 | 部分较大模型温度为 0 仍有波动 | 低温不能当作可复现性保证 |
| 单位变化 | 将 µM 改成 nM,指标也会变化,部分反而改善 | 要检查单位变换下的等价性,不能只看单次分数 |
| 增加伪边 | 多数模型的误差或排序表现恶化,也有例外 | 给错结构会传入参数阶段,模型不一定会纠正 |
“ground truth”主要是文献与仓库中已学习的网络参数,不全是独立随机干预实验给出的真实自然常数。部分变量范围也来自作者判断;这限制了对绝对误差的解读。
为什么“图对了”仍不够?
设结构是“batch size → 显存占用”。模型可能合理地解释 batch 越大显存通常越高,却无法仅凭这句话知道增量系数;模型尺寸、序列长度、KV 格式和实现都会改变数值。这个例子是 infra 类比,论文并未在 LLM 服务系统上实验。
不能扩大为结构发现结论
本文没有证明 LLM 擅长提出正确因果结构,也没有证明 LLM 永远不能估计参数。它表明:在该基准的无观测数据设置下,直接索取系数存在明显局限。把 LLM 用作结构候选生成器、再独立验证,是合理工程分工,仍需其他证据支持。
对 CKG 的启发(阅读判断)
数值条目应附测量、拟合或可信规格来源;LLM 估值只能标成待验证假设。至少检查重复估计波动、单位等价变换和结构扰动。测量与拟合也不能单独保证因果识别,仍需明确干预、混杂与模型假设。
相关:LLM-SR 展示结构提议与数据拟合的正向分工。
依据:原文 v2,方法见第 3 节,实验与结果见第 4–5 节,范围反馈见附录 C,指标和完整表见附录 D、G;核对日期:2026-10-24。