AgentMD: Empowering Language Agents for Risk Prediction with Large-Scale Clinical Tool Learning
核心思路
文献里散落着大量临床风险评分(如 CURB-65),但多数只以文字形式存在。AgentMD 先当工具制造者:从 PubMed 摘要中筛出评分方法,写成带说明和 Python 函数的结构化计算器,经核验后得到 2,164 个工具(RiskCalcs);再当工具使用者:读病历、检索并挑选适用的计算器、写代码调用、汇总结果。数值计算交给解释器,LLM 负责“选哪个、怎样从病历取参数、如何解读”。
1. 背景与问题
临床计算器(clinical calculator)把若干病人指标换算成风险。例如 HEART 评分估计胸痛患者短期心脏事件风险,CURB-65 估计社区获得性肺炎的死亡风险。它们有循证依据,使用时却有几重障碍:
| 障碍 | 表现 |
|---|---|
| 知道“该用哪个” | 医生要先熟悉成百上千种评分及其适用人群,新评分传播又慢 |
| 各自孤立 | 计算器通常单独使用,很少针对同一病人一起评估 |
| 与电子病历脱节 | 需要手工录入参数,费时也容易录错 |
| 解读不一致 | 同一项指标如何判定,不同人理解可能不同 |
让 LLM 直接“心算”风险并不可靠;已有工作给 LLM 配上计算器(如 OpenMedCalc 限于 MDCalc 上预选的工具),或像 Almanac 那样检索计算器的文字描述再让模型推理。本文要解决的是两件事:如何大规模、自动地造出计算器工具库,以及如何为具体病人选对并用对这些工具。
2. 方法与创新
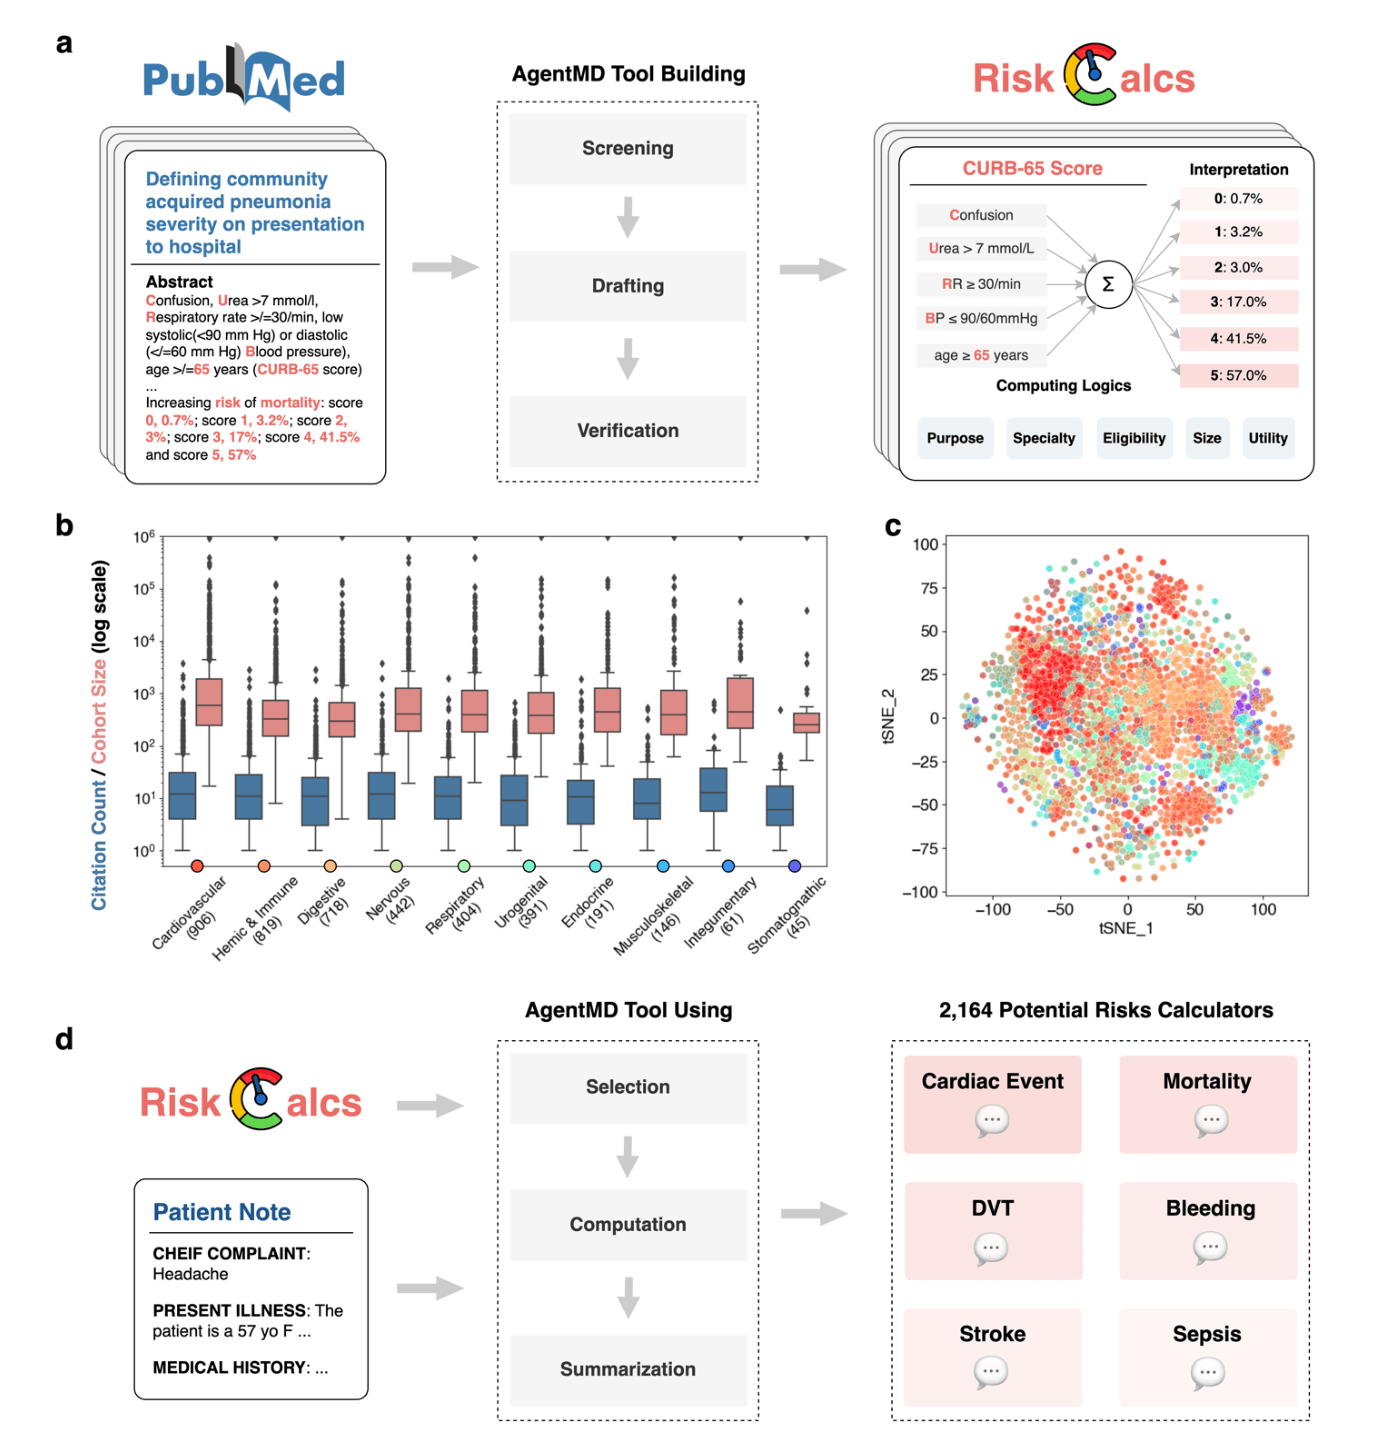
原论文图 1,v1 PDF 第 6 页。a 是造工具流程,d 是用工具流程;b、c 分别展示各器官系统的引用数/队列规模分布和工具语义嵌入的 t-SNE 图。
工具制造:从摘要到可执行计算器
flowchart LR
  A["PubMed 摘要<br/>(2000–2023.04)"] -->|布尔检索| B["339,952 篇"]
  B -->|GPT-3.5 筛选:<br/>是否提出新评分| C["33,033 篇"]
  C -->|GPT-4 起草| D["24,190 个候选工具"]
  D -->|GPT-4 按检查清单核验,<br/>全部通过才收录| E["RiskCalcs<br/>2,164 个工具"]
每个工具都是一份结构化文档:标题、用途(Purpose)、适用人群(Eligibility)、主题、计算逻辑(Python 函数)、结果解读(Interpretation)、效用(Utility)。GPT-4 还把每个工具归入 MeSH 的十个器官系统之一或多个,其中心血管系统最多,口腔颌面系统最少。
核验环节相当严格:候选中只有约 9% 被收录。这一步主要是 LLM 自检,人工评估只在之后抽样进行。
工具使用:选择 → 计算 → 汇总
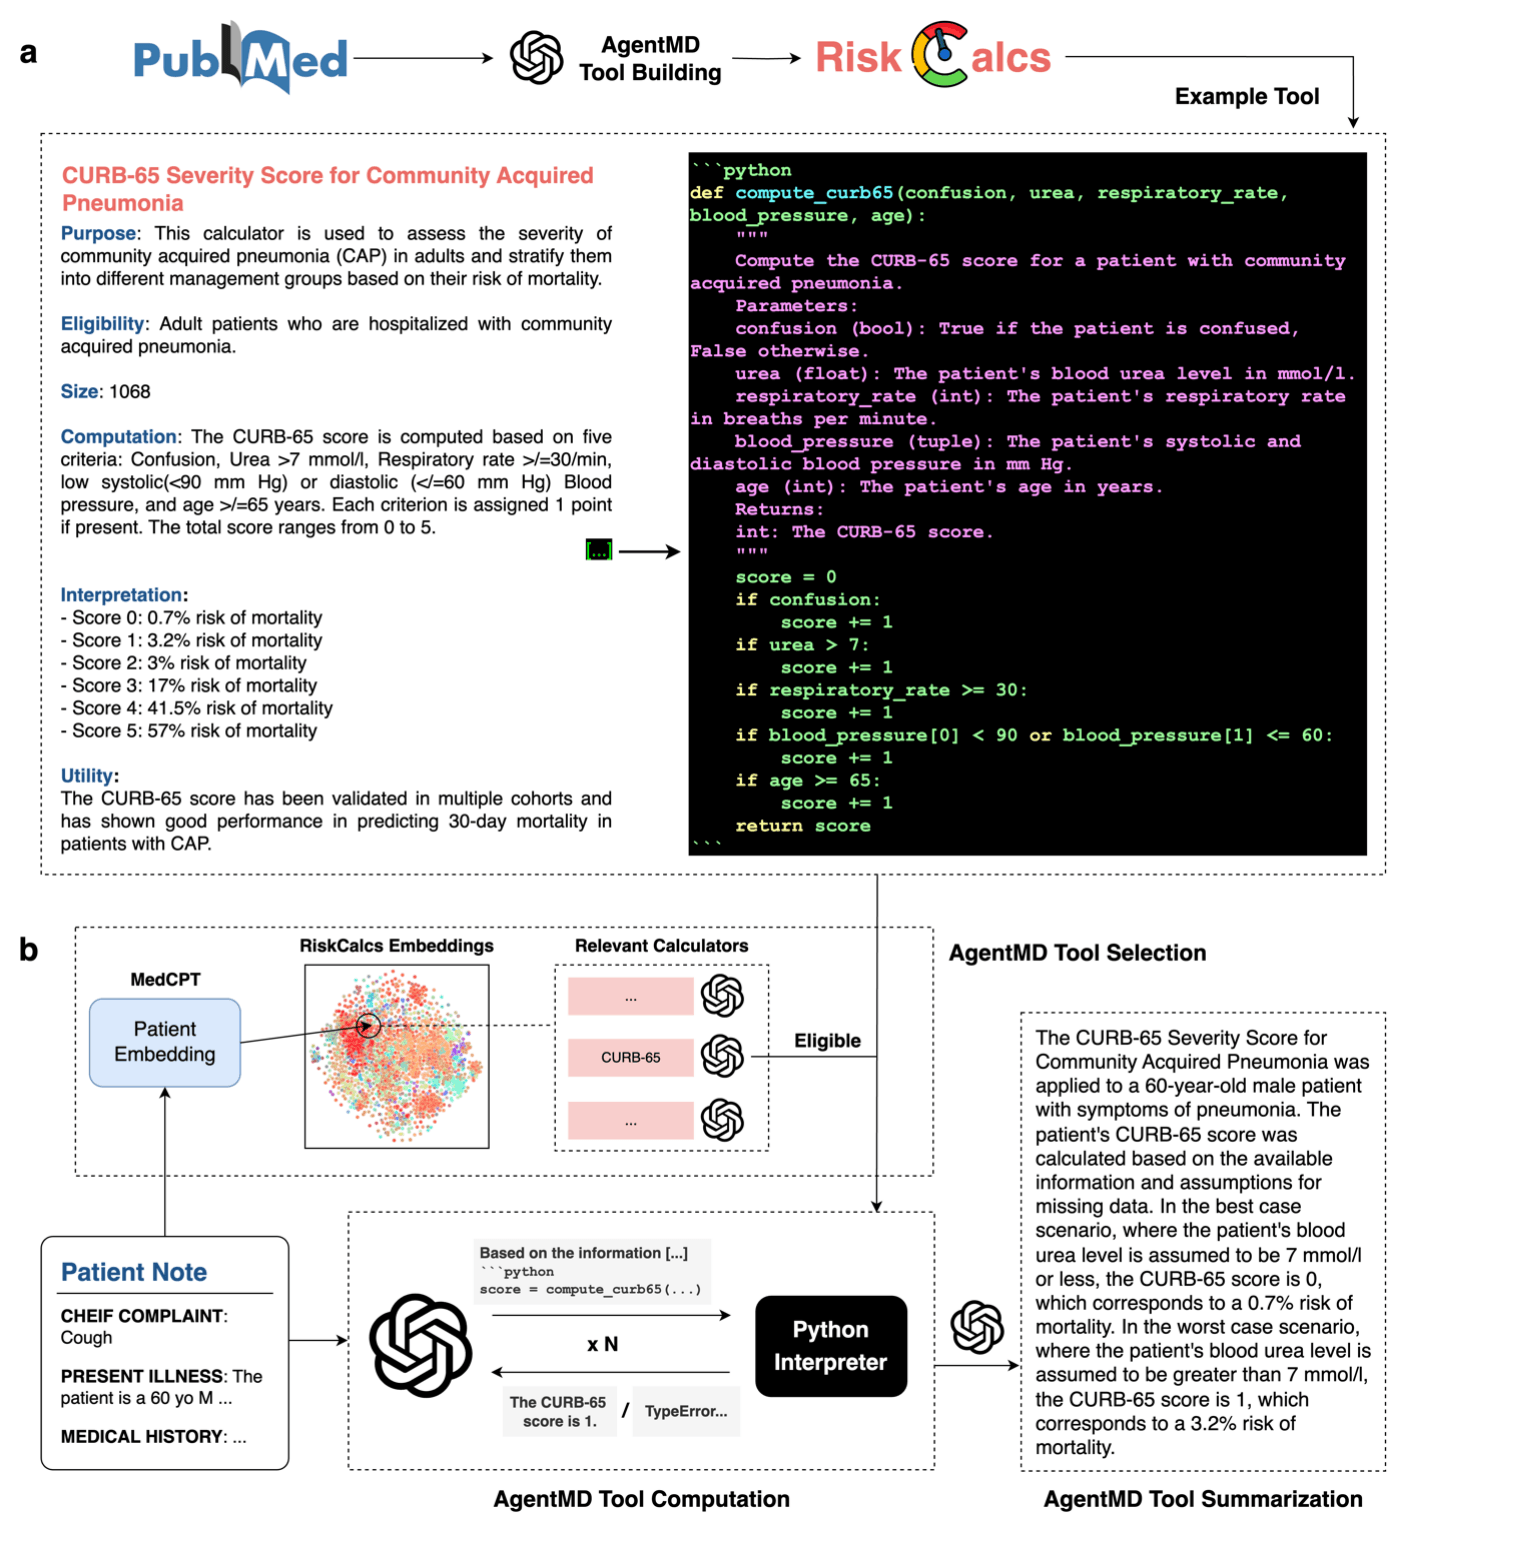
原论文图 2,v1 PDF 第 8 页。a 是从一篇摘要生成的 CURB-65 工具,左侧是说明,右侧是函数;b 是对一份病历的选择、计算和汇总过程。
| 步骤 | 做法 | 关键点 |
|---|---|---|
| 选择 | MedCPT 编码病历,在 Faiss 索引中取最相似的 10 个工具;LLM 再判断哪些对该病人适用 | 先用向量检索缩小范围,再由 LLM 判断适用性 |
| 计算 | LLM 从病历中提取或推断参数,写代码调用 RiskCalcs 函数;解释器返回结果或报错,LLM 可多轮修改 | 以 Summary: 开头的回复结束循环 |
| 汇总 | 把交互过程总结成一段风险说明 | 缺失参数时,按最好和最坏情况分别计算,给出风险区间 |
图 2b 中的例子:病历缺少血尿素值,最好情况下 CURB-65 为 0(死亡风险 0.7%),最坏情况下为 1(3.2%)。把缺失信息显式变成区间,比默默假设一个值更适合临床场景。
作者把创新概括为:首次用 LLM 大规模生成、评估并应用临床工具。与文字检索式做法相比,关键差别是工具被实现为可复用的函数,调用者只需把参数填对,计算本身由解释器保证。
3. 应用与效果
RiskCalcs 的质量与覆盖
人工评估两组各 50 个工具:引用数最高的 50 个,以及随机抽取的 50 个。三位标注者先独立标注,再讨论取共识。
| 评估项 | 结果 |
|---|---|
| 三个方面的正确率(摘要可用性、计算逻辑、结果解读) | 平均分别为 87.0%、87.6%、89.0% |
| 三方面全部正确 | 67.0% 的工具 |
| 数值计算核对(每个工具 5 组 GPT-4 生成的参数,共 500 次计算) | 仅 8.4% 与人工计算不一致;17.4% 与线上实现一致,74.2% 与依据摘要的人工计算一致 |
| 网上已有实现 | 引用前 25 名中 68.0% 有;第 25–50 名只有 28.0%;随机样本中 96.0% 没有任何线上实现 |
最后一项说明了 RiskCalcs 的价值:MDCalc 等人工维护的平台只覆盖热门评分,大量发表过的评分从未被做成可用工具。
RiskQA:选工具并算对
作者用 350 组已核验参数,由 GPT-4 扩写成 USMLE 风格的多选题;题目不说明该用哪个计算器。
| 方法 | GPT-3.5 | GPT-4 |
|---|---|---|
| CoT 提示 | 0.321 | 0.409 |
| AgentMD | 0.546 | 0.877 |
- 工具选择的 top-1 准确率:MedCPT 检索 0.723,GPT-4 版 AgentMD 0.823,GPT-3.5 版 0.663。选工具的能力明显依赖底座模型。
- 选错工具时,仍有 41.9%(26/62)答对,说明不同评分的结论存在冗余。
- 在直接告知正确工具的 RiskQA* 上:AgentMD > 提供摘要原文的 RAG > 只提供计算器名称。可见同一份知识,写成函数调用比作为文字参考更准确。
应用到 MIMIC-III 病历
对 9,822 份 ICU 入院记录,AgentMD 先为每位病人列出可能的风险,再逐项选工具计算,共用到 1,039 个计算器,平均每人 4.6 个。超过 60% 的病人(6,060 人)至少适用一个死亡率相关计算器,其次是心脏事件、卒中、呼吸系统事件、出血和感染。按计算器聚合后,还可以用 LLM 给出的特异性、严重程度、紧急程度及病历中是否已评估等分数,观察整个队列的风险分布。
证据边界
- RiskQA 由 GPT-4 从 RiskCalcs 中已经核验的工具生成,正确工具必然在库内;CoT 基线却没有工具库。它衡量的是“库内选择与计算”,并不等同于真实临床问题上的准确率。
- 质量评估只抽查了 100 个工具,计算核对的参数也由 GPT-4 生成;剩余两千多个工具的质量主要依靠 LLM 自检。
- MIMIC-III 部分是描述性分析,没有与真实结局对照,不能说明预测是否准确,也不能说明是否改善了临床决策。
- 工具只来自摘要,全文中的细节(例如完整评分表)可能遗漏;GPT-4 的成本与隐私问题限制本地部署。
对 CKG 的启发(阅读判断)
可借鉴的知识单元是“可执行函数 + 适用条件 + 结果解读 + 文献来源 + 核验状态”,而非单纯的文字描述。应用时先按适用条件过滤,再计算;参数缺失时输出区间而非臆测。“候选 2.4 万、收录 2,164”的严格门槛也提示:自动抽取的知识需要分级入库,并在条目上记录经过哪种核验(LLM 自检、人工抽查、外部实现对照)。
相关:LLM-DM 同样让 LLM 产出可执行模型、由外部引擎保证计算;PETSc Assistants 讨论围绕领域知识库的助手。
依据:原文 v1,工具构建与使用见 Results 前两节及 Online Methods,质量评估见 Fig. 3 一节,RiskQA 见 Fig. 4 一节,MIMIC-III 应用见 Fig. 5 一节,局限见 Discussions;核对日期:2026-10-28。