Leveraging Pre-trained Large Language Models to Construct and Utilize World Models for Model-based Task Planning
核心思路
不让 LLM 直接规划,而是让它写出世界模型:把每个技能的自然语言描述翻译成 PDDL 动作模型(前提条件与效果)。模型中的错误由验证器和人类用自然语言指出,LLM 负责翻译回 PDDL 并修正。修好的模型交给经典规划器搜索计划,或作为“廉价模拟器”检查 LLM 给出的计划。LLM 擅长提供常识与建模,可靠的组合搜索交给规划器。
1. 背景与问题
设定:智能体有一个技能库,每个技能只有一句话的描述,例如“用微波炉加热食物”;用户下达高层指令,需要排出一串可执行的技能序列。
直接用 LLM 做规划器的问题:
| 问题 | 说明 |
|---|---|
| 计划常常不可执行 | 即使给了 PDDL 或其自然语言版本,LLM 仍会忽略动作前提、处理不好长程依赖 |
| 反馈只能在线获得 | 计划执行后才发现错误;没有可靠模拟器时,试错代价高 |
| 同样的错误反复出现 | 换个场景又犯同类错误,人类要一遍遍给相同反馈 |
作者的判断是:LLM 从海量文本中学到了“动作需要什么、会造成什么”的知识,建模能力强于搜索能力。因此把规划拆成两部分:建模动作的因果依赖(交给 LLM)与找出达成目标的动作序列(交给规划器)。
PDDL 速览
经典规划问题写作 :领域 、初始状态 、目标 。领域包含谓词(状态变量)和动作;每个动作有参数、前提条件
precondition和效果effect(哪些谓词变真、哪些变假)。只要领域模型正确,Fast Downward 等领域无关规划器就能可靠地找到计划。
2. 方法与创新
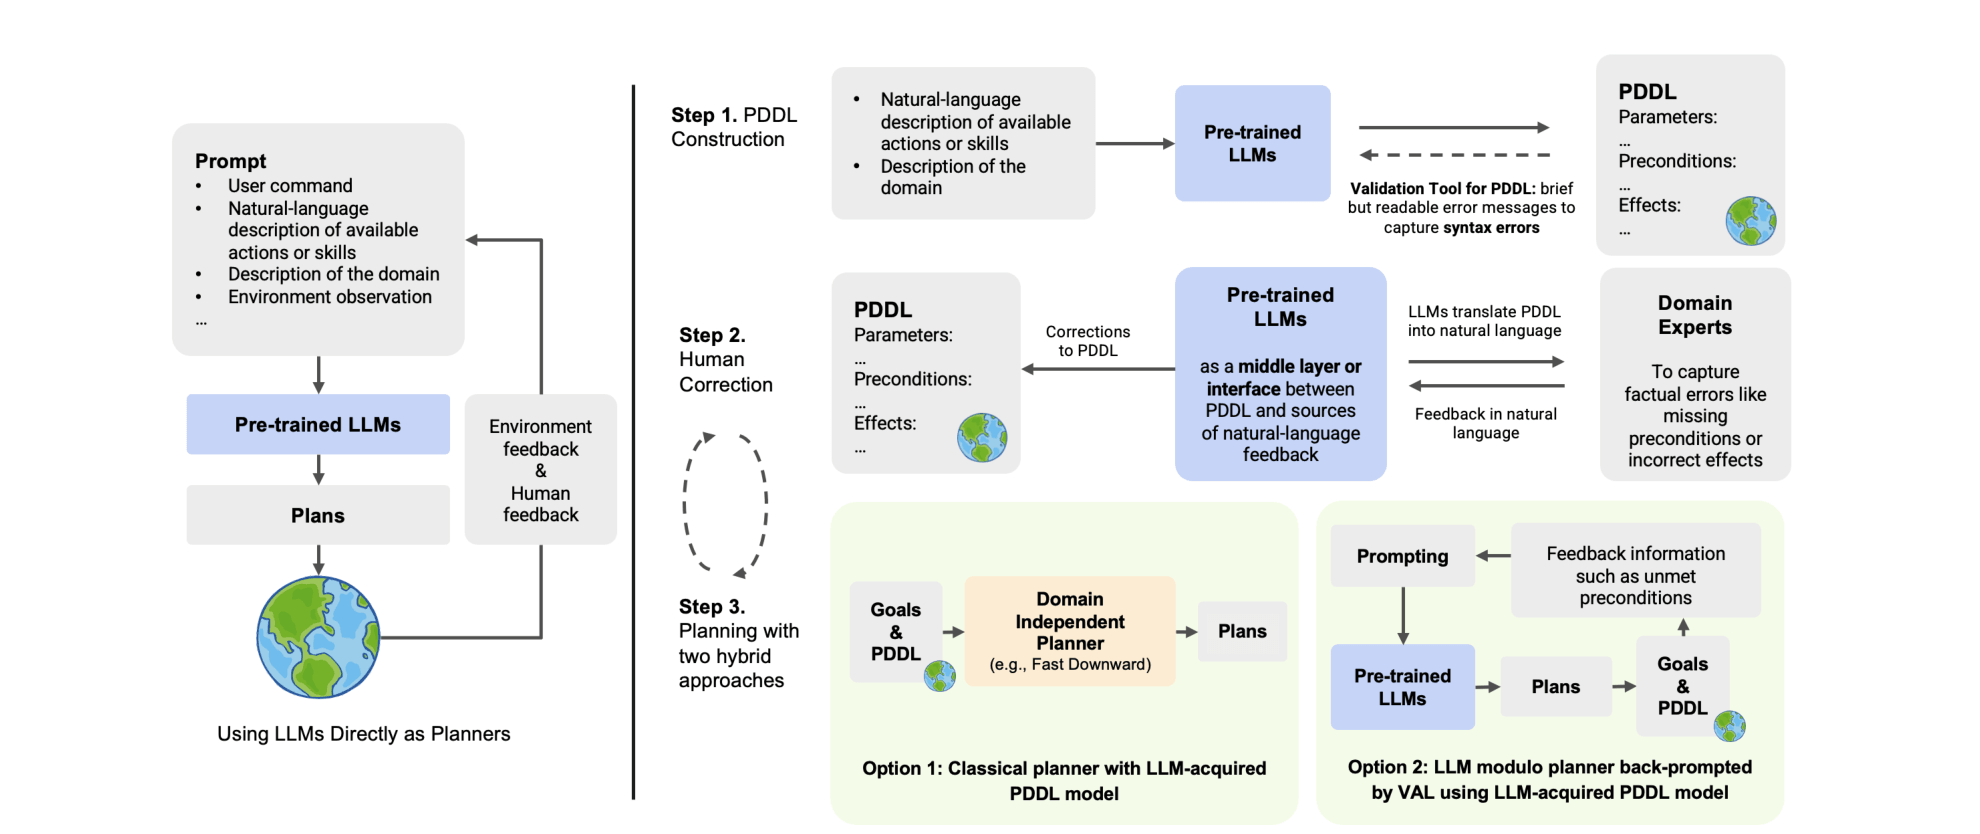
原论文图 1,v2 PDF 第 5 页。左侧是“LLM 直接当规划器”,右侧是本文的三步:构建 PDDL、人工纠错、两种规划方式。
第一步:逐个动作生成 PDDL
提示词包含五部分:任务说明、一两个其他领域(Blocksworld)的示例、当前领域描述(含机器人的物理限制,如只有一只手)、当前动作的描述,以及一个动态维护的谓词列表。
LLM 为每个动作输出参数、前提、效果,以及新定义的谓词及其自然语言解释。例如“打开小家电”的输出大致是:
Preconditions: (and ... (not (appliance-on ?o)))
Effects:       (and (appliance-on ?o))
New Predicates: (appliance-on ?o - householdObject):小家电 ?o 已打开
几个设计要点:
- 谓词列表初始为空,所有谓词由 LLM 自己创造,再供后续动作复用,保证符号一致。
- 跑两遍:第一遍结束后,把完整谓词表放入提示词再生成一次。例如“打开家具”动作中出现的“可打开”谓词,能提醒 LLM 其他动作也应检查这一条件。
- 每个谓词都要附自然语言描述:这样才能把 PDDL 转写成普通人能读懂的文字,也便于用 LLM 或视觉语言模型从环境描述中确定初始状态。
作者没有一次性生成整个领域,原因是提示词会过长,而后续纠错需要接着同一段对话进行(附录 A.2)。
第二步:以 LLM 为中介纠错
| 反馈来源 | 捕捉什么 | 怎么交给 LLM |
|---|---|---|
| 简单脚本与 VAL 验证器 | 语法错误:用了 forall 等不支持的关键字、谓词与类型重名、参数类型不匹配 | 直接把简短的错误消息发给 LLM |
| 领域专家 | 事实错误:缺少前提、漏写效果等 | 先由 LLM 把 PDDL 转写成自然语言给人看;人用自然语言反馈,例如“漏了一个效果:食物被捣碎后就不能再拿起” |
纠错的方式是重放并续写建模对话。作者认为,检查动作模型并不比检查计划更费脑:检查计划时,人本来就要在脑中模拟每个动作的前提与效果。更重要的是,模型一旦改对,同样的错误就不会在以后的计划中重复出现。
第三步:用模型规划
- 经典规划器 + LLM 构建的模型:LLM 只把用户指令翻译成 PDDL 目标,再由 Fast Downward 搜索计划。
- LLM 规划 + VAL 回提示(LLM modulo planner):LLM(ReAct,GPT-4)先给计划,VAL 用这份 PDDL 模型检查哪些前提或目标没满足,再把信息翻译成自然语言反馈给 LLM 重试。PDDL 模型在这里充当低成本模拟器和人类代理。
第二种方式更灵活:用户的顺序偏好(“先把土豆加热再捣碎”)无法用现有谓词表达,LLM 规划器却能直接遵守。
3. 应用与效果
实验在 2023 年 5 月进行,覆盖三个领域:两个 IPC 领域 Logistics、Tyreworld,以及作者构建的 Household 领域。Household 模拟一只机械臂的移动操作机器人,有 22 个技能,物理约束比 ALFWorld 更严格。
PDDL 构建质量
由熟悉 PDDL 的研究生标注并修正错误,以修改次数衡量生成模型与正确模型的距离。
| 领域 | 动作数 | 参数与字面量数 | GPT-4 错误 | GPT-3.5-Turbo 错误 |
|---|---|---|---|---|
| Household | 22 | 271 | 53 | 218+ |
| Logistics | 6 | 54 | 2 | 38 |
| Tyreworld | 13 | 108 | 4 | 94+ |
- GPT-4 共 59 个错误,只有 3 个是语法错误;其余是缺少前提或效果等事实错误。它会说 PDDL 的“语法”,但对动作的理解仍不完整。
- 典型失误:拿起物体时没考虑上面可能叠着别的东西(缺乏空间推理);偶尔给出自相矛盾的效果。
- GPT-3.5-Turbo 输出噪声很大,说明框架高度依赖 GPT-4 的符号能力。
- 只给极简动作描述、让 GPT-4 自行设计前提与效果时,约有 45 个错误,表明它也能辅助知识获取。
纠错
GPT-4 用 59 条反馈修好了 56 个事实错误;3 次额外反馈中,1 次是用户重复说明,2 次是 GPT-4 修改时引入了新错误。GPT-3.5-Turbo 则改不全,还会引入新错误。
规划成功率
| 方法 | Household(27 个任务) | Logistics(21 个任务) |
|---|---|---|
| 只用 LLM 规划 | 15% | 0% |
| Fast Downward + LLM 构建的模型 | 95% | 100% |
| LLM 规划 + VAL 回提示(最多 8 轮) | 48% | 33% |
- Fast Downward 的失败全部来自目标翻译错误,不是模型或搜索问题。
- 回提示虽有明显提升,GPT-4 却常常陷入循环,反复给出同一个计划,或在修复时引入新错误。
- 有趣的互补:LLM 计划都遵守了用户的顺序要求;经典规划器偶尔给出物理上可行但反常的动作,比如把暂时不用的刀放到烤面包机上,LLM 则很少这样做,显示它掌握了隐含的人类偏好。
证据边界
- 95%/100% 的规划成功率使用的是经过专家逐条纠正后的模型,并假设初始状态的谓词取值已准确给出。它证明的是“LLM 起草 + 人工修正”的流程可行,而非 LLM 一次生成即可直接使用。
- 纠错需要有人发现错误;作者附录 A.4 只给出了定位错误的初步办法,查错本身的成本没有量化。
- 只支持标准 STRIPS 风格、固定的对象类型和完全可观测;评测领域也比许多经典规划基准简单。
对 CKG 的启发(阅读判断)
值得借鉴的是“LLM 起草形式化知识,验证器查语法,人用自然语言查事实,修正写回模型本身”的循环:纠正一次,以后所有推理都受益,不必在每次回答后重复纠正。谓词必须配自然语言描述这一要求,也对应知识库中“每个符号都要有人可读的定义”。另外,两遍生成与动态谓词表是保持符号一致、减少重复概念的简单办法。
相关:MSA 同样让 LLM 按问题合成可执行模型,再由推断引擎保证一致性;AriGraph 则在交互中以知识图谱维护世界模型。
依据:原文 v2,构建与纠错方法见第 4 节,实验见第 5 节,语法反馈与查错方法见附录 A.3–A.4,Household 领域见附录 A.5;核对日期:2026-10-28。